23.找出字符串中第一个匹配项的下标
题目
给你两个字符串 haystack 和 needle ,
请你在 haystack 字符串中找出 needle 字符串的第一个匹配项的下标(下标从 0 开始)。
如果 needle 不是 haystack 的一部分,则返回 -1 。
示例 1:
- 输入:haystack = "sadbutsad", needle = "sad"
- 输出:0
- 解释:"sad" 在下标 0 和 6 处匹配。
- 第一个匹配项的下标是 0 ,所以返回 0 。
示例 2:
- 输入:haystack = "leetcode", needle = "leeto"
- 输出:-1
- 解释:"leeto" 没有在 "leetcode" 中出现,所以返回 -1 。
提示:
- 1 <= haystack.length, needle.length <= 104
- haystack 和 needle 仅由小写英文字符组成
方法一: 普通对比
class Solution:
    def strStr(self, haystack: str, needle: str) -> int:
        length = len(needle)
        for i in range(len(haystack)):
            if haystack[i] == needle[0]:
                if haystack[i: i+length] == needle:
                    return i
        return -1
class Solution {
    fun strStr(haystack: String, needle: String): Int {
        var index = -1
        var targetLength = needle.length
        for (i in targetLength..haystack.length) {
            if (haystack.substring(i - targetLength, i) == needle) {
                index = i - targetLength
                return index
            }
        }
        return index
    }
}
复杂度分析
-
时间复杂度:O(n×m),其中 n 是字符串 haystack 的长度,m 是字符串 needle 的长度。最坏情况下我们需要将字符串 needle 与字符串 haystack 的所有长度为 m 的子串均匹配一次。
-
空间复杂度:O(1)。我们只需要常数的空间保存若干变量。
方法二: KMP
上述的朴素解法时间复杂度是 O(m∗n) 的,而 KMP 算法的复杂度为 O(m+n)。
KMP算法是一种字符串匹配算法,可以在 O(n+m) 的时间复杂度内实现两个字符串的匹配。
KMP 之所以能够在 O(m+n) 复杂度内完成查找,是因为其能在「非完全匹配」的过程中提取到有效信息进行复用,以减少「重复匹配」的消耗。
KMP算法的核心,是一个被称为部分匹配表(Partial Match Table)的数组。
特有名词
所谓字符串匹配,是这样一种问题: 字符串P是否为字符串S的子串?如果是,它出现在S的哪个位置。
- S称为主串。
- P称为模式串或子串。
KMP算法的主要步骤就是:
- 根据要查找的子串(模式串)字符串构造一个next部分匹配表(匹配表数组的长度是子串的长度)
- 遍历主串字符串,当遍历失败时,查询next部分匹配表,定位子串接着与主串比较的位置(不用每次都把主串索引退回到上次遍历的索引加1了,
而是直接调整子串的位置,让尽可能的少次数去比较,减少复杂度)
简单总结就是next匹配表其实就是子串(模式串)字符串的最长前缀和后缀的长度(也就是子串当中又有重复的字符部分,那对于重复的部分来说就不用再和主串进行第二次比较了)。
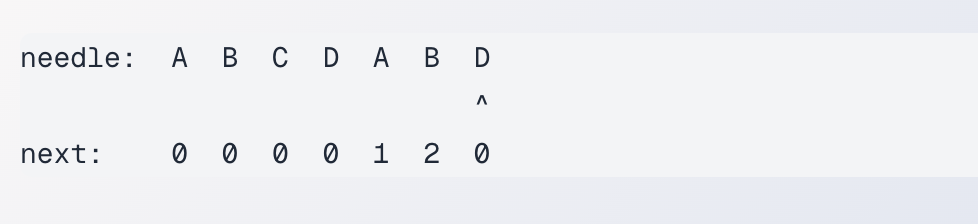
假设在上面箭头的D处这里和主串匹配不上了,这个时候不用再把模式串(子串)退回到索引0继续匹配,我们只要退回到索引2开始就可以了,因为这个时候主串当前位置前面的两个元素一定是AB,AB是重复的,所以直接子串直接跳到AB后的一个元素去对比就好了。
算法原理
在方法一的暴力匹配的模式是这样的:
haystack: A B A B C A B C
needle:     A B C
第1轮:从 haystack[0] 开始
i 是主串的索引,j 是子串的索引
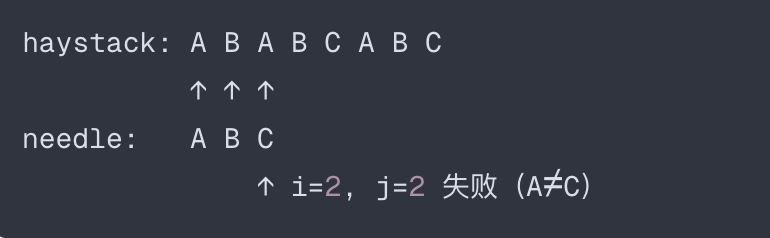
失败了。暴力的做法:i 回退到 1,j 回退到 0,重新开始。
第二轮: 从 haystack[1] 开始
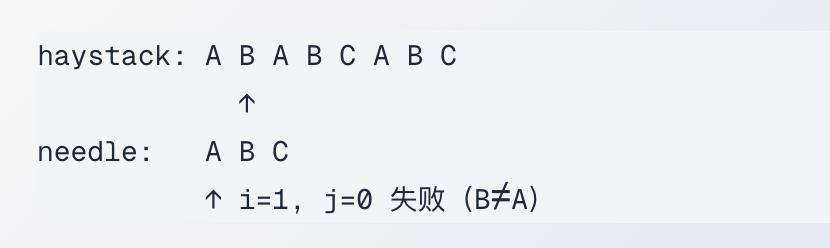
然后一直以此类推,每次失败,i都要往回跑,之前比较过的内容全部丢弃,重复劳动
现在回头看第一轮失败的瞬间:
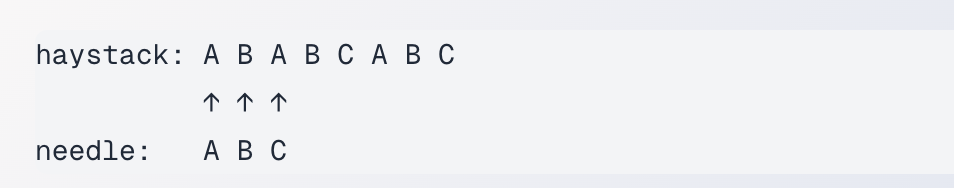
此时 i = 2, j = 2,已经成功匹配到了AB
暴力遍历选择把这个信息扔掉,i 退回 1 重来,但是对KMP 来说: 我们已经知道了 haystack[0 .. 1] = AB,为什么不利用这个信息呢?
i 不动, 只回退 j。
j 回退意味着: needle向右滑动,从needle的某个靠前位置继续比较。
那 j 应该回退到哪里?
这就是next数组要解决的问题。
原则:失败前已匹配的部分是 needle[0..j-1],我们在这段里找最长的一段,它的前缀 = 后缀(前面和后面字符重复),然后把 j 跳到这个长度。
为什么要前缀=后缀?因为:
- 后缀 = haystack 中已经比过的部分的末尾(确定存在)
- 前缀 = needle 的开头(下一轮要从这里继续)
- 两者相等,就意味着 needle 可以直接滑动过来对齐,不需要重新比这段
用图说明:
下面假设needle是ABAB:
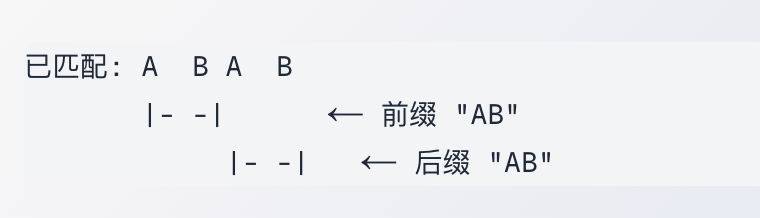
前缀 = 后缀,长度为 2
所以 j 跳到 2,相当于 needle 向右滑动,前两个字符 "AB" 已经对齐好了,直接从 j=2 继续比。
用图说明暴力遍历
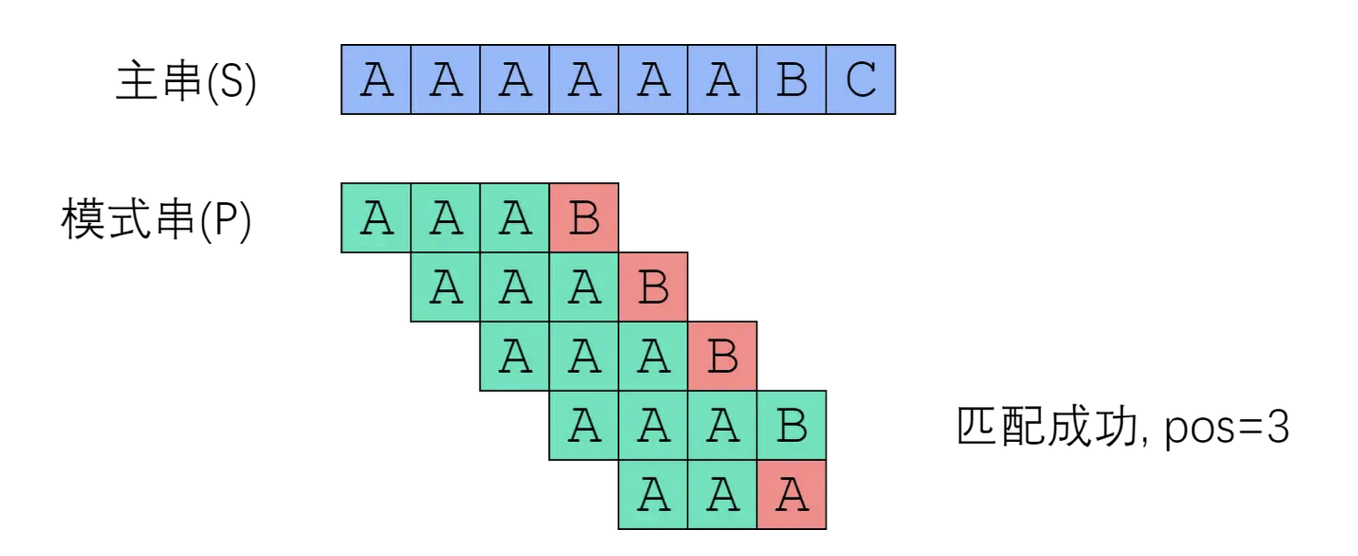
这就是Brute-Force 算法。现在,我们需要对它的时间复杂度做一点讨论,它的时间复杂度是O(n×m)。
我们很难降低字符串比较的复杂度(因为比较两个字符串,真的只能逐个比较字符)。
因此,我们考虑降低比较的趟数。如果比较的趟数能降到足够低,那么总的复杂度也将会下降很多。
要优化一个算法,首先要回答的问题是“我手上有什么信息?” 我们手上的信息是否足够、是否有效,决定了我们能把算法优化到何种程度。请记住:尽可能利用残余的信息,是KMP算法的思想所在。
在Brute-Force中,如果从S[i]开始的那一趟比较失败了,算法会直接开始尝试从S[i+1]开始比较。
这种行为,属于典型的“没有从之前的错误中学到东西”。
我们应当注意到,一次失败的匹配,会给我们提供宝贵的信息:
- 如果 S[i : i+len(P)] 与 P 的匹配是在第 r 个位置失败的,那么从 S[i] 开始的 (r-1) 个连续字符,一定与 P 的前 (r-1) 个字符一模一样!
- 为什么呢? 因为不然得话你在r之前就失败了。
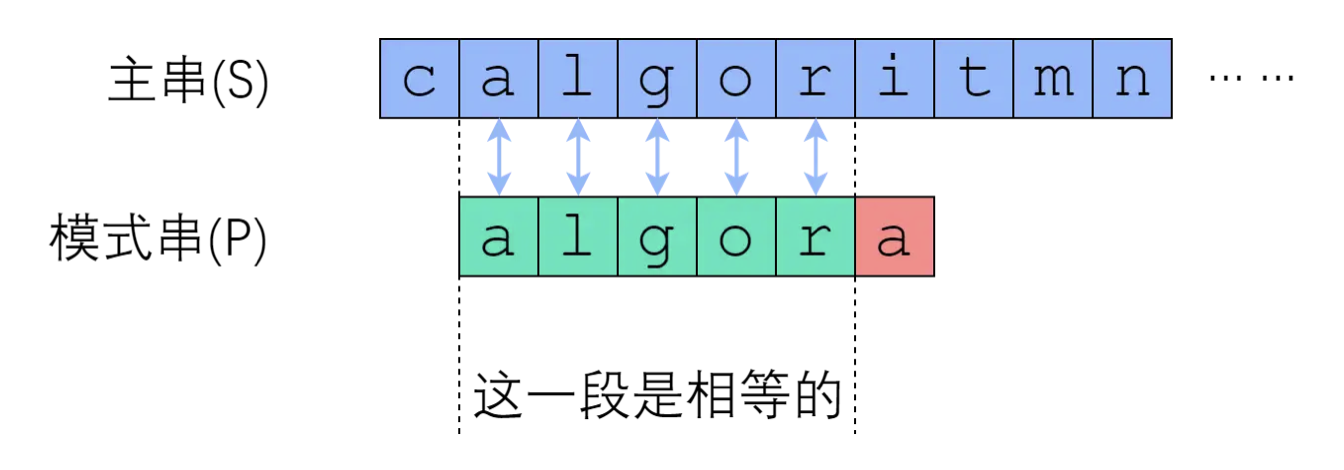
需要实现的任务是“字符串匹配”,而每一次失败都会给我们换来一些信息——能告诉我们,主串的某一个子串等于模式串的某一个前缀。但是这又有什么用呢?
有些趟字符串比较是有可能会成功的;有些则毫无可能。
我们刚刚提到过,优化 Brute-Force的路线是“尽量减少比较的趟数”,而如果我们跳过那些绝不可能成功的字符串比较,则可以希望复杂度降低到能接受的范围。
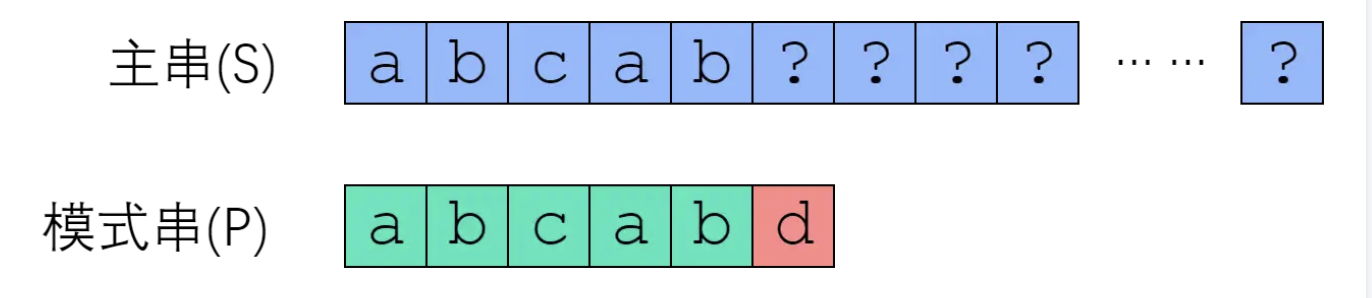
那么,哪些字符串比较是不可能成功的?来看一个例子。已知信息如下:
- 模式串 P = "abcabd".
- 和主串从S[0]开始匹配时,在 P[5] 处失配。
-
既然是在 P[5] 失配的,那么说明 S[0:5] 等于 P[0:5],即"abcab".
-
现在我们来考虑:从 S[1]、S[2]、S[3] 开始的匹配尝试,有没有可能成功?
-
从 S[1] 开始肯定没办法成功,因为 S[1] = P[1] = 'b',和 P[0] 并不相等。
-
从 S[2] 开始也是没戏的,因为 S[2] = P[2] = 'c',并不等于P[0].
-
但是从 S[3] 开始是有可能成功的——至少按照已知的信息,我们推不出矛盾。
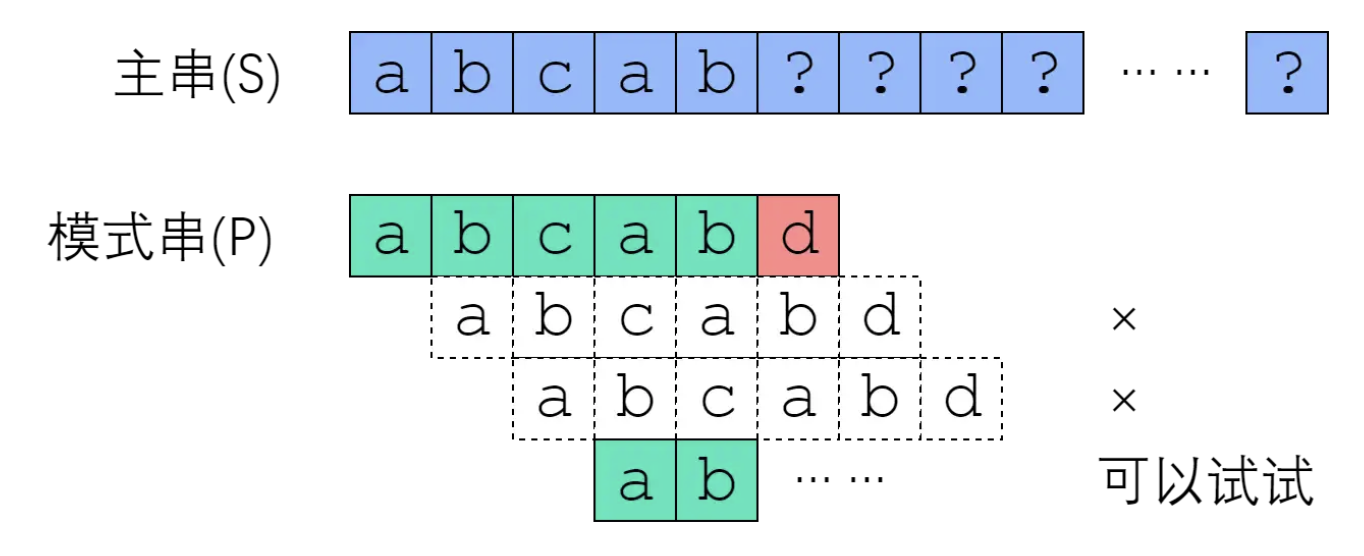
也就是说当主串的某个字符c发生不匹配时,如果主串回退,最终还是会重新匹配到字符c上。
那干脆不回退,岂不美哉!
也就是说主串一直遍历不回退。
主串不回退,那模式串必须回退尽可能少,并且模式串回退位置的前面那段已经和主串匹配,这样主串才能不用回退。
如何找到模式串回退的位置呢?
在不匹配发生时,前面匹配的那一小段字符对于主串和模式串都是相同的(如果不相同,在这之前会就匹配失败了)。
那既然这一小段是主串和模式串相同的。那我就用这个串的头部去匹配这个串的尾部,最长的那段就是答案,也就是模式串该回退到的位置。
带着“跳过不可能成功的尝试”的思想,我们来看next数组。
那就假设模式串在其所有位置上都发生了不匹配,模式串在和主串匹配前把其所有位置的最长匹配都算出来(算个长度就行),生成一张表,之后我俩发生不匹配时直接查这张表就行。这就是next数组。
next数组
next数组是对于模式串(子串)而言的。
next 数组的本质:最长相等前后缀
先定义两个概念(针对一个字符串):
- 前缀:包含首字符、不含尾字符的所有连续子串。如 "abab" 的前缀有 "a"、"ab"、"aba"。
- 后缀:包含尾字符、不含首字符的所有连续子串。如 "abab" 的后缀有 "b"、"ab"、"bab"。
next[j] 定义为:模式串 needle[0..j] 这一段子串中,最长相等前后缀的长度。
P 的 next 数组定义为:next[i] 表示 P[0] ~ P[i] 这一个子串,使得前k个字符恰等于后k个字符的最大的k. 特别地,k不能取i+1(因为这个子串一共才 i+1 个字符,自己肯定与自己相等,就没有意义了)。
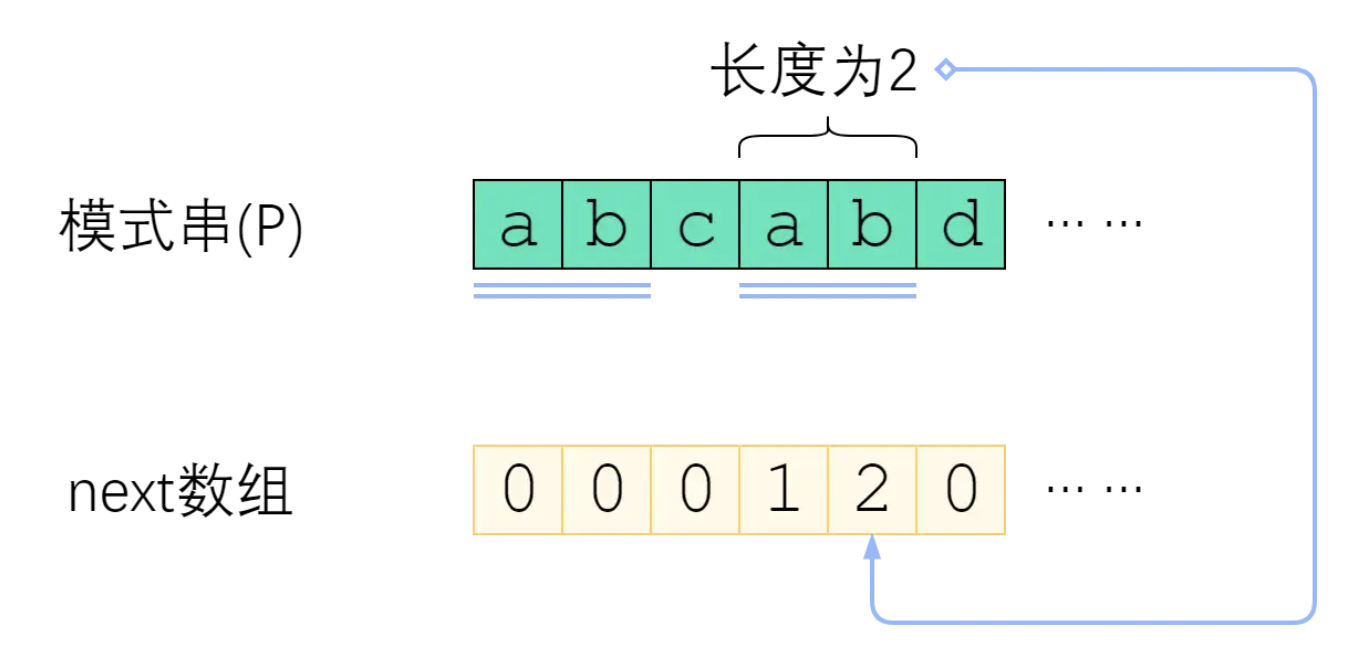
上图给出了一个例子。P="abcabd"时,next[4]=2,这是因为P[0] ~ P[4] 这个子串是"abcab",前两个字符与后两个字符相等,因此next[4]取2.
而next[5]=0,是因为"abcabd"找不到前缀与后缀相同,因此只能取0.
如果把模式串视为一把标尺,在主串上移动,那么 Brute-Force 就是每次失配之后只右移一位;改进算法则是每次失配之后,移很多位,跳过那些不可能匹配成功的位置。但是该如何确定要移多少位呢?
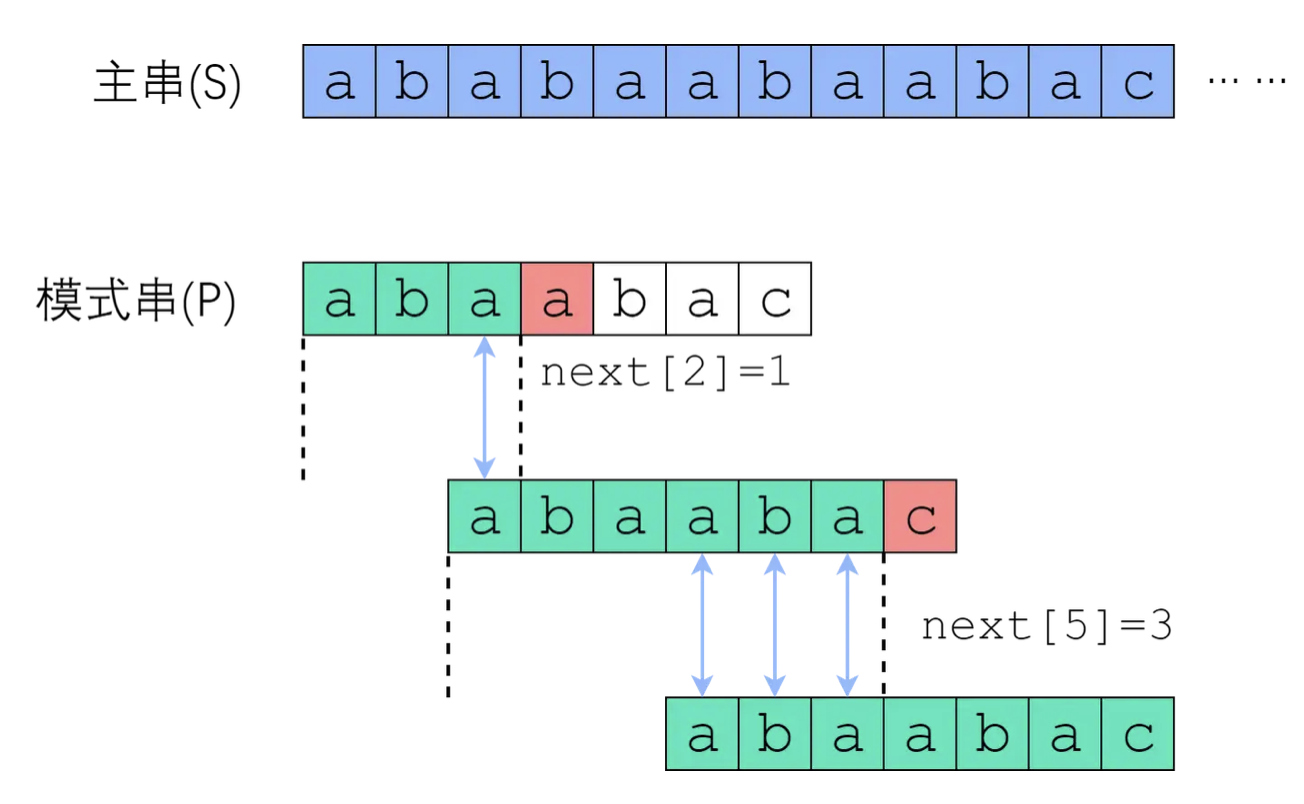
-
在 S[0] 尝试匹配,失配于 S[3] != P[3] 之后,我们直接把模式串往右移了两位,让 S[3] 对准 P[1].
-
接着继续匹配,失配于 S[8] != P[6], 接下来我们把 P 往右平移了三位,把 S[8] 对准 P[3].
-
此后继续匹配直到成功。
我们应该如何移动这把标尺?很明显,如图中蓝色箭头所示,旧的后缀要与新的前缀一致(如果不一致,那就肯定没法匹配上了)!
了解了利用next数组加速字符串匹配的原理,我们接下来代码实现之。分为两个部分:
-
建立next数组
-
利用next数组进行匹配。
next数组简历规则
next数组是匹配串的一个查找表,它的定义可以用下面一句话来解释。就是kmp算法的本质:
next数组的每个元素表示匹配串中从起始到以当前字符结尾的子串中以当前字符结尾的连续重复最长串长度。
字符串abcdabe,len是每个子串以最后一个字符结尾的连续重复最长串长度:
- next[0] = 0 // 子串'a'中没有包含以'a'结尾的连续重复子串,len = 0
- next[1] = 0 // 子串'ab'中没有包含以'b'结尾的连续重复子串,len = 0
- next[2] = 0 // 子串'abc'中没有包含以'c'结尾的连续重复子串,len = 0
- next[3] = 0 // 子串'abcd'中没有包含以'd'结尾的连续重复子串,len = 0
- next[4] = 1 // 子串'abcda'中包含以'a'结尾的连续重复子串是'a',len = 1
- next[5] = 2 // 子串'abcdab'中包含以'b'结尾的连续重复子串'ab',len = 2
- next[6] = 0 // 子串'abcdabe'中没有包含以'e'结尾的连续重复子串,len = 0
匹配过程与计算next的思路相似,如果当前字符不匹配,就往回跳,跳多少呢,就是前面已比较串的以最后一个字符结尾的连续最长重复长度,最长也就一半,不用跳到开头,即next[j-1]的长度,不用再重头比较,
快速求next数组
终于来到了我们最后一个问题——如何快速构建next数组。
- 首先说一句:快速构建next数组,是KMP算法的精髓所在,核心思想是“P自己与自己做匹配”。
为什么这样说呢?回顾next数组的完整定义:
-
定义 “k-前缀” 为一个字符串的前 k 个字符; “k-后缀” 为一个字符串的后 k 个字符。k 必须小于字符串长度。
-
next[k]定义为:
P[0]~P[k]这一段字符串,使得k-前缀恰等于k-后缀的最大的k.
这个定义中,不知不觉地就包含了一个匹配——前缀和后缀相等。
构建 next 本质上是 模式串自己和自己做匹配。用双指针:
- j(慢指针):指向当前「前缀末尾」,同时 j 的值就是当前最长相等前后缀的长度。
- i(快指针):遍历整个串,指向「后缀末尾」。
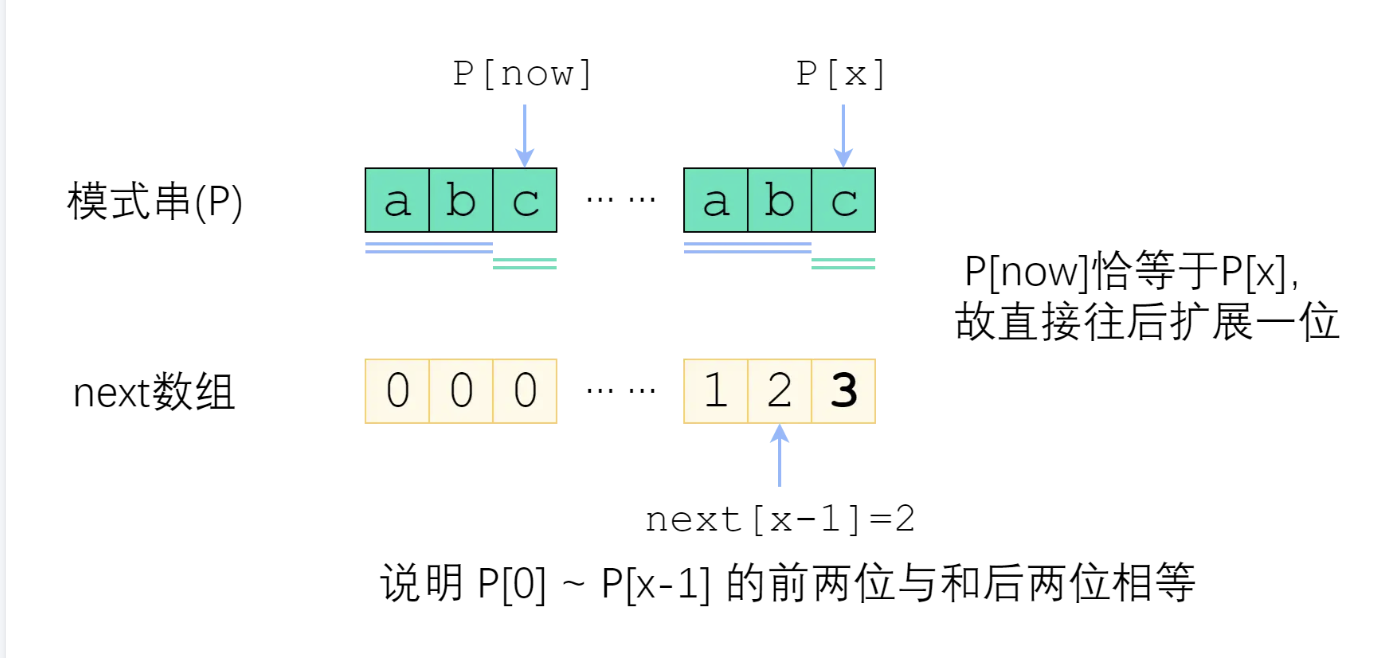
接下来,我们考虑采用递推的方式求出next数组。如果next[0], next[1], ... next[x-1]均已知,那么如何求出 next[x] 呢?
来分情况讨论。
首先,已经知道了 next[x-1](以下记为now),如果 P[x] 与 P[now] 一样,那最长相等前后缀的长度就可以扩展一位,很明显 next[x] = now + 1. 图示如下。
刚刚解决了 P[x] = P[now] 的情况。那如果 P[x] 与 P[now] 不一样,又该怎么办?
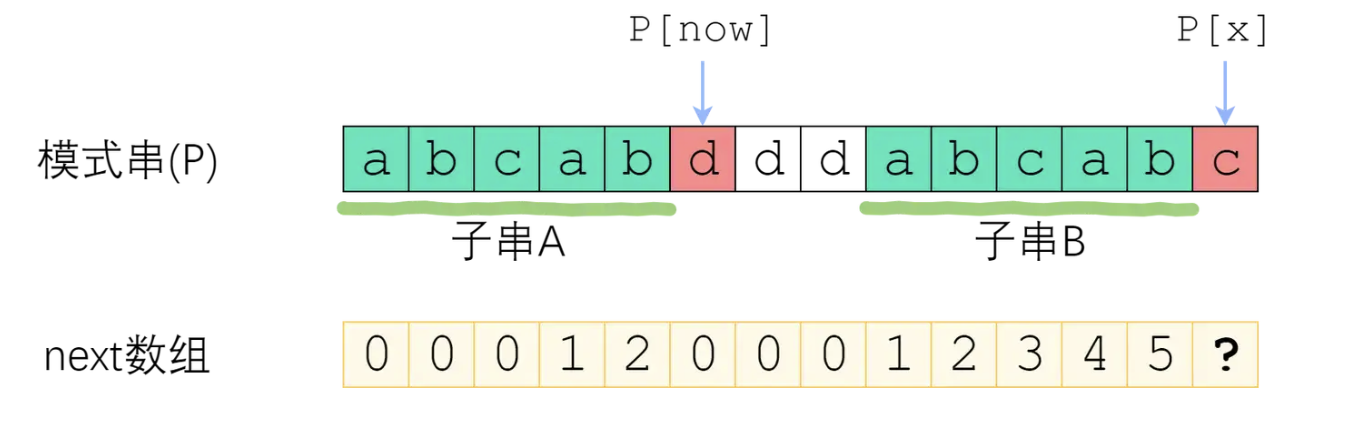
如图。
长度为now的子串A和子串B是P[0]~P[x-1]中最长的公共前后缀。
可惜 A 右边的字符和 B 右边的那个字符不相等,next[x]不能改成now+1了。
class Solution {
    fun strStr(haystack: String, needle: String): Int {
        val n = haystack.length
        val m = needle.length
        if (m == 0) {
            return 0
        }

        val next = buildNext(needle)
       //  构建好 next 后,主匹配的逻辑和构建过程几乎一模一样(同样是双指针 + 失配回退)
        // needle(模式串、子串) 的匹配指针
        var j = 0
        // i 是主串指针,全程只增不减,永不会退
        for (i in 0 until n) {
            // 失配时,j 回退到 next[j-1],直到 j=0 或字符匹配
            while (j > 0 && haystack[i] != needle[j]) {
                j = next[j - 1]
            }
            if (haystack[i] == needle[j]) {
                j++
            }
            // 模式串全部匹配完成
            if (j == m) {
                return i - m + 1
            }
        }
        return -1
    }

    // 构建 next 数组
    fun buildNext(needle: String): IntArray {
        val m = needle.length
        val next = IntArray(m)
        // 指向“前缀末尾”,同时它的值就是当前最长公共前后缀的长度。
        var prefixLen = 0
        // 从1开始,因为next[0]一定是0,单字符无前后缀
        for (i in 1 until m) {
            // 尝试在已有前后缀的长度基础上扩展
            // prefixLen 代表:needle[0..prefixLen-1] == needle[i-prefixLen..i-1]
            //  现在问:needle[prefixLen] == needle[i] 吗?能扩展一位吗?
            // 如果不等,且当前prefixLen还能回退(> 0)就缩短前后缀再试
            while (prefixLen > 0 && needle[i] != needle[prefixLen]) {
                //  失配后回退到更短的前后缀
                prefixLen = next[prefixLen - 1]
            }
            // 如果能扩展,就加长度
            if (needle[i] == needle[prefixLen]) {
                prefixLen++
            }
            next[i] = prefixLen
        }
        return next
    }
}
回退为什么是 next[prefixLen - 1]? 这是最难理解的一步。
失配回退用的是 next[j-1],而不是「j 减一」 这是你这个问题最容易混淆的点。当 p[i] != p[j] 时,naive 思路是 j-- 一格一格往回退着试。但 KMP 写的是:
j = next[j - 1] // 不是 j-- ! 为什么?因为当长度为 j 的前后缀延长失败时,我们要找的是次长的公共前后缀。而「p[0..j-1] 这段子串的最长公共前后缀长度」这个答案,早就在更早的循环里算好并存进 next[j-1] 了。
也就是说,回退不是线性地一格一格倒退搜索,而是一步跳到已经算好的次优解。这一步跳跃可能很大(比如从 100 直接跳到 2),它复用了之前的计算成果。这正是把 O(m²) 砍成 O(m) 的地方。
如果你真的写成 j 从大到小递减、每个长度都重新逐字符比对前缀和后缀是否相等,那就完全丢掉了 next 数组的复用价值,退化成暴力。 这个答案已经存在于 next[prefixLen-1] 中,直接复用,避免重复计算。
needle:  A B A B C
                ↑ i=4, needle[i]='C'
prefixLen=2, 比较 needle[4] vs needle[2] → C≠A,失败
回退: prefixLen = next[1] = 0
比较 needle[4] vs needle[0] → C≠A,还是失败
next[4] = 0
用 aabaaf 走一遍next函数
初始 next[0]=0, j=0:
| i | p[i] | 比较过程 | j 变化 | next[i] |
|---|---|---|---|---|
| 1 | a | p[1]=a == p[0]=a,匹配 | 0→1 | 1 |
| 2 | b | p[2]=b != p[1]=a,j>0 退到 next[0]=0;p[2]=b != p[0]=a,j=0 停止 | 1→0 | 0 |
| 3 | a | p[3]=a == p[0]=a,匹配 | 0→1 | 1 |
| 4 | a | p[4]=a == p[1]=a,匹配 | 1→2 | 2 |
| 5 | f | p[5]=f != p[2]=b,退到 next[1]=1;p[5]=f != p[1]=a,退到 next[0]=0;p[5]=f != p[0]=a,j=0 停止 | 2→0 | 0 |
结果 next = [0,1,0,1,2,0]。
buildNext 本质上是用 needle 匹配自身——用已经算好的 next 值加速求后续的 next 值,和主函数用 next 加速匹配是完全相同的逻辑。