5.LangChain
什么是LangChain
LangChain由 Harrison Chase 创建于2022年10月,它是围绕LLMs(大语言模型)建立的一个框架,LLMs使用机器学习算法和海量数据来分析和理解自然语言,GPT4、GPT5是LLMs最先进的代表,国内字节的豆包、百度的文心一言、阿里的通义千问也属于LLMs。
LangChain自身并不开发大模型,它的核心理念是为各种LLMs实现通用的接口,把LLMs相关的组件“链接”在一起,简化LLMs应用的开发难度,方便开发者快速地开发复杂的LLMs应用。LangChain目前有两个语言的实现:python、nodejs。
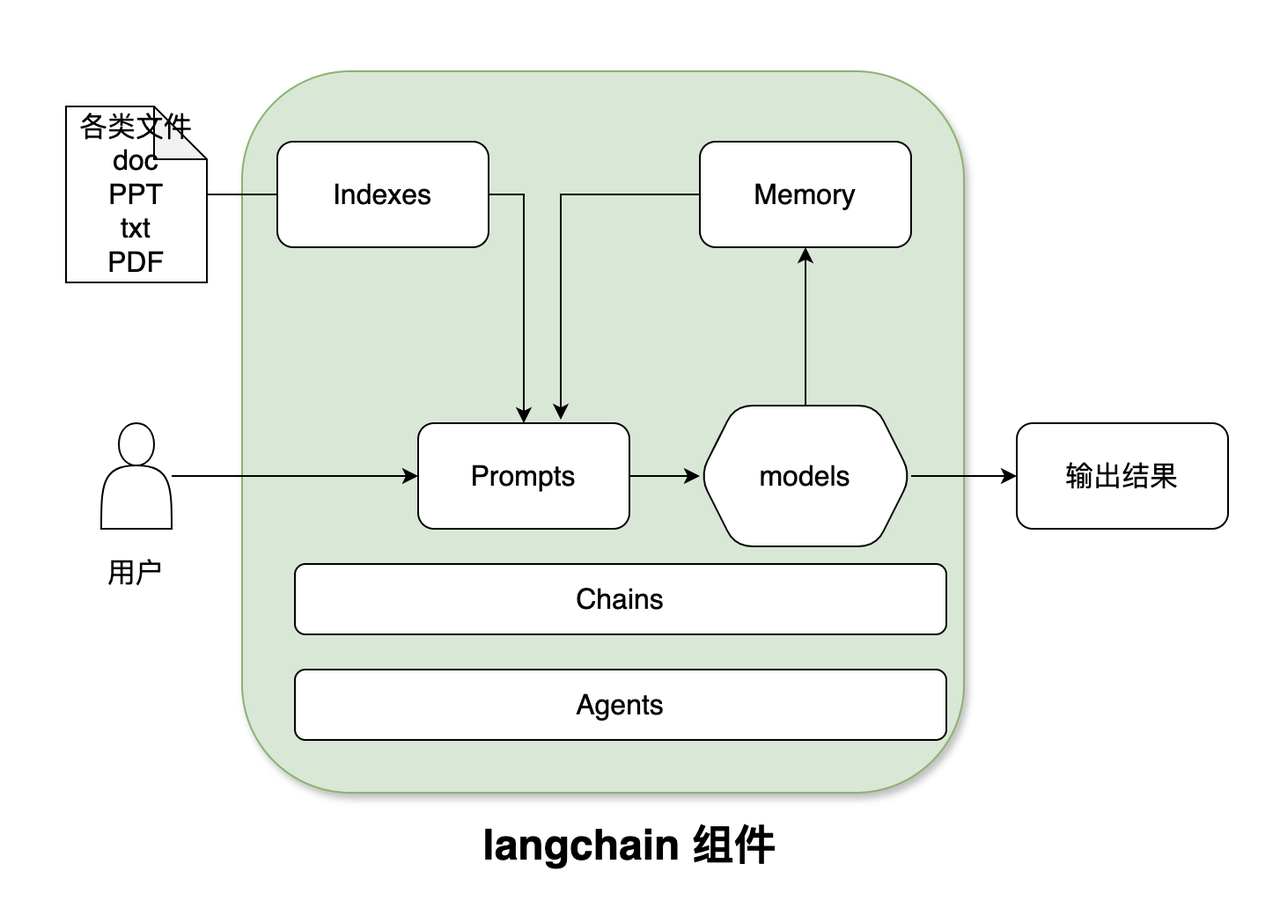
一个LangChain的应用是需要多个组件共同实现的,LangChain主要支持6种组件: - Models:模型,各种类型的模型和模型集成,比如GPT-4 - Prompts:提示词,包括提示管理、提示优化和提示序列化 - Memory:记忆,用来保存和模型交互时的上下文状态 - Indexes:索引,用来结构化文档,以便和模型交互 - Chains:链,一系列对各种组件的调用 - Agents:代理,决定模型采取哪些行动,执行并且观察流程,直到完成为止
现在市面上的模型多如牛毛,各种各样的模型不断出现,LangChain模型组件提供了与各种模型的集成,并为所有模型提供一个精简的统一接口。 LangChain目前支持三种类型的模型:LLMs、Chat Models(聊天模型)、Embeddings Models(嵌入模型). - LLMs: 大语言模型接收文本字符作为输入,返回的也是文本字符. - 聊天模型: 基于LLMs, 不同的是它接收聊天消(一种特定格式的数据)作为输入,返回的也是聊天消息. - 文本嵌入模型: 文本嵌入模型接收文本作为输入, 返回的是浮点数列表. LangChain支持的三类模型,它们的使用场景不同,输入和输出不同,开发者需要根据项目需要选择相应。
LangGraph
LangChain 家族出品。它把智能体流程建模成状态机(State Machine),并画成有向图(Directed Graph)。核心抽象三件套:
- State(状态):一个全局共享的数据结构(通常是 TypedDict),记录任务进行到哪了。所有节点都能读它、改它——它就是流程的"任务档案袋";
- Node(节点):一个个普通 Python 函数,收状态、干活、返回"要更新哪些字段";
- Edge(边):节点间的连线。条件边(Conditional Edges)通过一个判断函数看当前状态,动态决定下一步跳哪——分支和循环全靠它。
这种设计的革命性之处在于它天然支持循环,使得构建能够进行迭代、反思和自我修正的复杂智能体工作流变得前所未有的直观和简单。
其他框架
框架的本质是把每个项目都要重写的脏活标准化:消息路由、循环控制、结构化输出、状态管理。代价是学习成本、黑盒感、绑定风险。
四框架四个核心抽象:
- AutoGen=群聊
- AgentScope=消息
- CAMEL=角色扮演
- LangGraph=状态图
Chain
Runnable 是 LangChain 中可以调用、批处理、流式传输、转换和组合的工作单元。 Runnable 接口是使用 LangChain 组件的基础,它在许多组件中实现,例如语言模型、输出解析器、检索器、编译的 LangGraph 图等。
Runnable 接口强制要求所有 LCEL 组件实现一组标准方法,其实就是一套统一的接口,统一了LangChain当中组件的调用方法,都用invoke()方法。
LangChain 表达式语言(LCEL,LangChain Expression Language)是一种从现有的Runnable 构建新的 Runnable 的声明式方法,用于声明、组合和执行各种组件(模型、提示、工具、函数等)。 我们称使用 LCEL 创建的 Runnable 为“链”,“链”本身就是 Runnable。 其实就是LangChain中的一种语法。
RAG文档加载
数据源可能包含多种格式的文件,如文本文档、Markdown,PDF 等。因此我们首先需要对各种格式的文件进行处理。LangChain 实现和集成了众多文档加载器,方便从不同格式的文件中加载数据。可在 https://docs.langchain.com/oss/python/integrations/document_loaders 查看所有集成的文档加载器。 LangChain 所有文档加载器都实现了 BaseLoader 接口,接口提供了通用的 load(一次加载所有文档) 与 lazy_load(以延迟方式加载文档) 方法,用于从数据源加载数据并处理为 Document 对象。 LangChain 实现了 Document 抽象,用于表示文本单元及其元数据,它包含三个属性: - page_content:文本内容字符串。 - metadata:包含元数据的字典,如文档的来源等。 - id:可选,文档标识符。
PDF 存在多种来源格式,包括扫描版(图片 PDF)、电子文本版、混合版。并且布局格式也多种多样,包括单列布局、双列布局甚至竖排文本布局。并且包含段落、标题、页眉页脚、表格、数学公式、化学式、特殊符号、图片等各种元素。 因此,PDF 解析存在很多挑战。对于复杂 PDF,需要进行文本提取、布局检测、表格解析、公式识别等处理。
UnstructuredPDFLoader是对 unstructured 库的封装。支持布局识别与 OCR 提取文字。 使用UnstructuredPDFLoader,需要先下载 Poppler 和 Tesseract OCR。 Poppler 是一个开源的 PDF 文档处理库,用于渲染、解析和操作 PDF 文件。下载解压后将 .../poppler-24.08.0/Library/bin 添加到环境变量 Path 中即可。 Tesseract OCR 用于提取图片中的文字,在安装时需要选择 Additional language data(download) 来添加中文语言包。
MinerU
MinerU 提供了 PDF、Word、PPT、图片等文件的解析,支持图像提取、OCR、公式、表格解析等功能。 调用在线服务:https://mineru.net/apiManage/docs。可以从本地批量上传文件进行解析,并接收解析结果。
文档切分策略
- 按照固定字符数或 Token 数来切分,但可能会在不适当的位置切断句子。
- 递归使用多个分隔符切分,同时尽量保证字符数或 Token 数不超出限制。能保证不切断完整的句子。
- 语义切分:根据文本的语义内容切分,旨在保持相关信息的集中和完整,适用于需要高度语义保持的场景。但处理速度较慢,且可能出现不同块之间长度极不均衡的情况。具体切分过程为:将相邻的几个句子拼成一个句组。对所有句组进行嵌入,并比较嵌入向量的距离,找到语义变化大的位置,根据阈值确定切分点(比如计算相邻句子嵌入向量的余弦距离,取距离分布的第 N 百分位值作为阈值,高于此值则切分)。按照切分点切分出若干个语义段,并合并某些长度很短的语义段。
RecursiveCharacterTextSplitte(递归字符文本切分器)是最常用的切分器,它由一个字符列表作为参数,默认列表为 ["\n\n", "\n", " ", ""],并且会尝试按顺序使用这些字符进行切分,直到块足够小。由此尽可能地将所有段落(然后是句子,最后是词)保持在一起,因为这些段落通常看起来是语义上最相关的文本片段。 同时为了保证段之间语义完整,可以设置每个块之间有一部分重叠。
from langchain_unstructured import UnstructuredLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

docs = UnstructuredLoader(
    file_path="assets/sample.md",
    mode="elements", #Single返回单个Document对象,elements按标题等元素切分文档
).load()
print(docs)

chunks = RecursiveCharacterTextSplitter(
    separators=["\n\n", "\n", "。", "!", "?", "……", ",", ""],  # 分隔符列表
    chunk_size = 400,   # 每个块的最大长度
    chunk_overlap = 50,   # 每个块重叠的长度
    length_function = len,   # 可选:计算文本长度的函数,默认为字符串长度,可自定义函数来实现按 token 数切分
    add_start_index = True,   # 可选:块的元数据中添加此块起始索引
).split_documents(docs)

print(f"chunks {chunks}")
文档嵌入
使用嵌入模型生成文档的嵌入向量,后续检索时用于与查询的嵌入向量进行相似度计算。
2018年谷歌推出的 BERT 能够将文本嵌入为简单的向量表示,但是 BERT 并未针对有效生成句子嵌入进行优化,由此促使了 Sentence-BERT 的诞生。Sentence-BERT 调整了 BERT 的架构以及预训练任务以生成包含语义的句子嵌入向量,这些嵌入向量可以通过余弦相似度等相似性指标轻松进行比较,大大降低了查找相似句子等任务的计算开销。
常用嵌入模型:
- bge-large-zh 北京智源研究院(BAAI) 开源,向量维度1024,序列长度512
- bge-base-zh BAAI 开源,向量维度768,序列长度512
- bge-small-zh BAAI 开源,向量维度512,序列长度512
- bge-m3 BAAI 开源,多语言,向量维度1024,序列长度8192
- text-embedding-3-small OpenAI 多语言,向量维度1536,序列长度8192
- text-embedding-3-large OpenAI 多语言,向量维度3072,序列长度8192
LangSmith
使用 LangChain 构建的许多应用程序都包含多个步骤,需要多次调用 LLM。随着这些应用程序变得越来越复杂,能够检查链或 Agent 内部的具体情况变得至关重要。最好的方法是使用 LangSmith。
注册 LangSmith,在 Settings ➡️ API Keys 下创建 API-Key 并复制。之后在环境变量中添加以开始记录跟踪: LANGSMITH_TRACING="true" LANGSMITH_API_KEY="..." 配置好环境变量之后,可在 LangSmith 的 Tracing Projects 中查看跟踪记录。
Agent创建
from pprint import pprint
from langchain.agents import create_agent
from langchain_core.tools import tool
from langchain_ollama import ChatOllama
from pymilvus import MilvusClient, DataType


# ===== LangChain Agent 示例:LLM 用本地 ollama 的模型 =====

# 1. 用 @tool 装饰器定义工具。
#    函数名 -> 工具名,docstring -> 工具描述(LLM 靠它决定何时调用),类型注解 -> 参数 schema。
#    这三样都会发给模型,所以 docstring 要写清楚,别省略。
@tool
def get_collection_stats(collection_name: str) -> dict:
    """查询 Milvus 中指定集合(collection)的统计信息,比如实体数量。"""
    # 这里返回假数据,方便离线跑通示例;接真实 Milvus 时换成
    # client.get_collection_stats(collection_name=collection_name)
    return {"collection": collection_name, "row_count": 1024}


@tool
def multiply(a: int, b: int) -> int:
    """计算两个整数的乘积。"""
    return a * b


# 2. 本地 ollama 模型。要求该模型支持 tool calling(qwen2.5、llama3.1 等支持)。
#    默认连 http://localhost:11434,端口不同用 base_url 指定。
llm = ChatOllama(
    model="qwen2.5:7b",
    temperature=0,  # agent 场景建议 0,减少工具调用参数的随机性
)

# 3. create_agent 返回一个编译好的 LangGraph 图,内部就是
#    "调用模型 -> 若有 tool_calls 则执行工具 -> 把结果回灌给模型" 的循环,直到模型不再请求工具。
agent = create_agent(
    model=llm,
    tools=[get_collection_stats, multiply],
    system_prompt="你是一个向量数据库运维助手。需要具体数值时必须调用工具获取,不要自己猜。",
)

# 4. 输入输出都是 messages 列表(LangGraph 的 state)。
result = agent.invoke(
    {
        "messages": [
            {"role": "user", "content": "collection 'docs' 里有多少条数据?如果每条数据要存 3 个向量,一共是多少个向量?"}
        ]
    }
)

# messages 依次是:HumanMessage -> AIMessage(tool_calls) -> ToolMessage -> ... -> AIMessage(最终回答)
for message in result["messages"]:
    message.pretty_print()

# 只要最终答案:
pprint(result["messages"][-1].content)