Agent
在以chatgpt的大模型出现以后,模型具备了“思考”能力,能够帮助我们解决一些知识获取和推理等问题。但是因为大模型只能输出内容,能够帮助我们解决的业务问题有限,如果能让大模型具备使用工具的能力,将很大程度上拓宽大模型能力的边界。 于是基于大模型+工具调用这种解决方案,“智能体”和“Agent”这个概念在业界出现并大火。
智能体,又称Agent。是指能够感知环境、分析信息、自主决策并采取行动以实现特定目标的软件实体或系统。它以大模型(如GPT等)为“大脑”,具备理解、规划、决策、记忆和行动的能力。AI Agent = LLM+ 记忆 + 任务规划 + 工具使用
传统的大模型就像一个“百科全书”,知识渊博,有问必答,但它不会主动去“做”什么事。而智能体则像一个“全能助理”,比如你告诉它“我下周三要去杭州出差,帮我安排好行程”,它就能自主完成查询航班、预订酒店、规划市内交通、提醒天气等一系列操作 。它不仅“有脑”(能思考),还“有手有脚”(能调用工具去执行)。
大模型是无法感知或改变外接环境的
之前阶段的模型只能 输入文字 -> 输出文字,但现实任务往往需要行动:
- 查实时天气得联网
- 算数得用计算器
- 查你的文档得检索
- 发邮件得调邮件接口
但模型自己做不了这些。
Agent = 大模型(大脑) + 工具(手脚) + 循环决策(自主性)
你给Agent一个目标,它会自己思考需要哪些步骤、每一步调用什么工具、根据结果决定下一步,直到完成任务。
一个类比:
-
纯模型 = 一个被关在房间里、只能动嘴的顾问,你问什么他答什么,但他不能起身做任何事。
-
Agent = 给这个顾问配了电脑、电话、双手,并告诉他你可以自己用这些工具去把事做成。
基石: Tool / Function Calling (函数调用)
这是Agent的核心机制,它让模型能请求调用你写的函数。
关键要理解一件反直觉的事: 模型本身不能执行任何代码。
它能做的是 -- 告诉你 我想调用get_weather这个函数,参数是city = 北京,真正执行函数的是你的程序,执行完把结果再喂回给模型。
完整流程:
- 你告诉模型:我有这些工具可用(附上每个工具的名字、功能、参数说明)
- 用户提问:"北京今天天气怎么样?"
- 模型判断:这需要调 get_weather 工具 → 返回"请调用 get_weather(city='北京')"
- 【你的程序】真正执行 get_weather("北京") → 得到"晴,25℃"
- 你把结果喂回给模型
- 模型基于结果,生成人话回复:"北京今天晴,25 度,很适合出门。"
Android功能类比:
像极了系统权限回调 -- App(模型)不能直接读取通讯录,它得请求这个能力,由系统(你的程序)实际执行后把结果回调给它。 模型请求调用工具,你的代码实际执行并回传。
代码实现
第一步: 定义工具函数(就是普通Python函数)
def get_weather(city: str) -> str:
    return f"{city}今天晴,25℃"

def calculate(expression: str) -> str:
    return str(eval(expression))
第二步: 用模型能理解的格式描述这些工具
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询指定城市的当前天气",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "城市名,如 北京"}
                },
                "required": ["city"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "calculate",
            "description": "计算一个数学表达式",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {"type": "string", "description": "如 2 * (3 + 4)"}
                },
                "required": ["expression"],
            },
        },
    },
]
这上面的description极其重要 -- 模型就是靠它判断该不该用、怎么用这个工具。
如果描述写的含糊,模型就会用错或不用。把它当成写给模型看的API文档。
第三步: 把工具告诉模型,并处理它的调用请求
import json

def run_agent(user_input):
    messages = [{"role": "user", "content": user_input}]

    while True:  # 这个循环是 Agent 的灵魂,见 3.3
        response = client.chat.completions.create(
            model="模型名称",
            messages=messages,
            tools=tools,   # 告诉模型有哪些工具
        )
        msg = response.choices[0].message
        messages.append(msg)

        # 模型没有要求调工具 → 说明它已能直接回答,结束
        if not msg.tool_calls:
            return msg.content

        # 模型要求调用一个或多个工具
        for tool_call in msg.tool_calls:
            name = tool_call.function.name
            args = json.loads(tool_call.function.arguments)

            # 【你的程序】真正执行对应函数
            if name == "get_weather":
                result = get_weather(**args)
            elif name == "calculate":
                result = calculate(**args)

            # 把执行结果喂回给模型
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": result,
            })
        # 循环回到开头,模型拿到工具结果后决定下一步
上面代码里面while True就是Agent区别于普通一问一答的关键。
那怎么来解决这个问题呢?
就是通过让大模型调用对应的工具Tool,就可以,例如:
- 读写文件内容
- 查看文件列表
- 运行终端命令
Agent运行模式
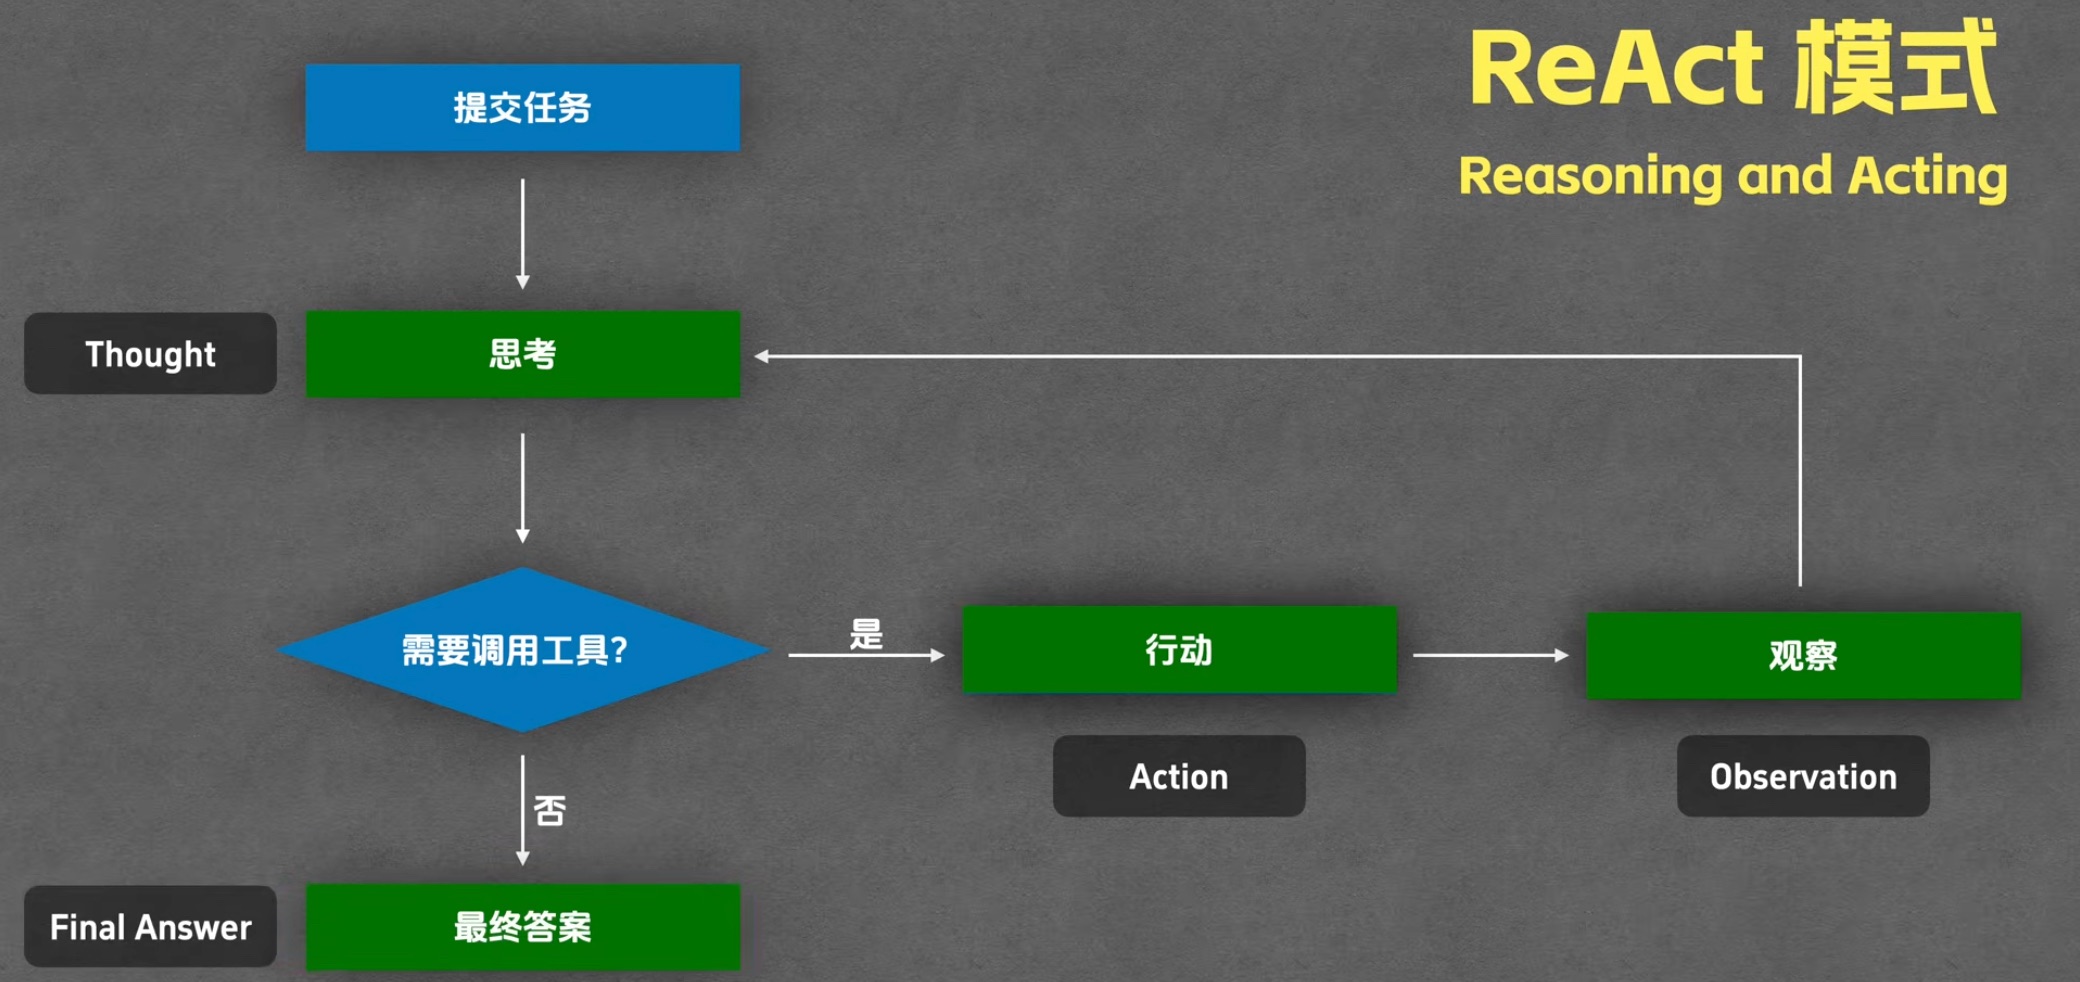
ReAct模式
思考与行动: Reasoning and Acting,简单总结就是边想边干,每步根据观察决定下一步。
ReAct = Reasoning(推理) + Acting(行动)的循环
想(Reason) : 我需要做什么? -> 做(Act): 调用工具 -> 看(Observe): 结果如何? 然后一直一轮轮的循环上面的过程,直到它认为任务完成。
这里有个非常关键的工程问题: LLM本质上只会生成文字,它没有手,怎么让它真的去调用工具?
答案是约定一种固定格式,让LLM的每次回答都写成两行:
- Thought: 用户想知道北京的天气。我需要调用天气查询工具。
-
Action: get_weather(city="北京")
-
Thought(思考): LLM用大白话写出它此刻的分析和计划 -- 相当于让它想出声,我们能看见它的思路
- Action(行动): 它决定要执行的具体操作,写成工具名(参数名=参数值)的样子。
然后由一段普通程序(术语叫解析器,Parser,可以理解为"传令兵")盯着这个输出:一看到 Action: get_weather(city="北京"),就真的去调用查天气的函数,拿到结果后再把结果翻译成一句人话喂回给 LLM:
- Observation: 北京当前天气为晴,气温25摄氏度,微风。
所以整个魔法可以概括成一句话:LLM 负责动脑(生成 Thought 和 Action 文字),一段普通代码负责动手(解析 Action、真正执行、把结果喂回去)。 两者一配合,"只会说话"的模型就变成了"能干活"的智能体
举个多步的例子:
用户: 帮我查下明天北京适不适合跑步
- 想: 需要知道明天天气 -> 做: 调get_weather -> 看: 下雨
- 想: 小于不适合户外跑步 -> 已有足够信息 -> 结束,回复用户建议改室内跑步
Plan And Execute
先拆完整计划,再逐项执行。
智能体的运行机制
智能体不是一锤子买卖,它靠一个循环反复运转来完成任务,术语叫智能体循环(Agent Loop):
感知 --> 思考 --> 行动 --> 观察结果 --> 再感知 --> .....
Workflow和Agent的差异
简单来说,Workflow是让AI按部就班的执行指令(按剧本演),而Agent则是赋予AI自由度去自主达成目标(给目标,自由发挥)。
Workflow工作流是一种传统的自动化范式,其核心是对一系列任务或步骤进行预先定义的、结构化的编排。 其本质 上是一个精确的、静态的流程图,规定了在任何条件下、以何种顺序执行哪些操作。
Workflow是步骤写死在代码里,LLM只负责每步内容。
一个典型的案例: 某企业的费用报销审批流程。员工提交报销单(触发) -> 如果金额小于500元,直接由部分经理审批 -> 如果金额大于500元,先由部门经理审批,再流转至财务总监审批 -> 审批通过后,通知财务部打款。
这个过程的每一步,每一个判断条件都被精确地预先设定。
与工作流不同,基于大语言模型的智能体是一个具备自主性的,以目标为导向的系统。
它不仅仅是执行预设指令,而是能够再一定程度上理解环境、进行推理、指定计划,并动态的采取行动以达成最终目标。
LLM在其中扮演者大脑的角色,一个典型的例子,就是智能旅行助手。
当我们向它下达一个新指令,例如你好,请帮我查询一下今天北京的天气,然后根据天气推荐一个合适的旅游景点。
它的处理过程充分展现了其自主性:
-
规划与工具调用: Agent首先会把任务拆解成两个步骤: 1. 查询天气,2.基于天气推荐景点。随即,它会自主选择并调用天气查询API,并将 北京作为参数传入
-
推理与决策: 假设API返回的结果是晴朗,微风。Agent的LLM大脑会基于这个信息进行推理: 晴天适合户外运动,它 会根据这个判断,在它的知识库或通过搜索引擎这个工具中,筛选出北京的户外景点,如故宫、颐和园、天坛公园等。
-
生成结果: 最后Agent会综合信息,给出一个完整的、人性化的回答: 今天北京天气晴朗,微风,非常适合户外旅游,为您 推荐前往颐和园,你可以在昆明湖上泛舟,欣赏美丽的皇家园林景色。
在这个过程中,没有任何写死的 if天气=晴天 then 推荐颐和园 的规则。如果天气是“雨天”,Agent 会自主推理并推荐国家博物馆、首都博物馆等室内场所。这种基于实时信息进行动态推理和决策的能力,正是 Agent 的核心价值所在。
AI智能体发展史
AI 发展的主线是"问题驱动":每代范式都是为了解决上一代的死穴——规则写不完,所以改成让机器学;只会感知不会决策,所以有了强化学习;从零试错太笨,所以先预训练。
大致分三个阶段:
-
第一阶段符号主义,代表是专家系统和 SHRDLU,信念是"智能等于摆弄符号",1976 年纽厄尔和西蒙的物理符号系统假说是它的理论基石。它在封闭领域很成功——MYCIN 的诊断水平达到人类专家,深蓝 1997 年赢了国际象棋世界冠军。但它撞上三堵墙:知识获取瓶颈(规则要人手写,专家的经验很多说不清)、常识无底洞(Cyc 项目手工录常识几十年收效有限)、框架问题和脆弱性(世界一变就失灵,遇到规则外的情况直接崩,不是降级)。
-
第二阶段是学习,分三级台阶。连接主义(1986 年反向传播进入主流,2012 年后深度学习爆发)解决了感知;强化学习(TD-Gammon → AlphaGo)解决了序贯决策,核心是最大化累积回报而不是眼前奖励;预训练(自监督学习 + 微调)真正解开了知识获取瓶颈——因为"猜下一个词"不需要人工标注,全互联网的文本都变成了训练数据。
-
第三阶段是会师。 现代智能体用 LLM 当大脑(连接主义的产物),干的活是推理和规划(符号主义的梦想),用 RLHF 打磨(行为主义),多 Agent 协作放大(明斯基 1986 年的心智社会)。有意思的是,LLM 内部没有可区分的符号,但它输出的 Thought/Action 全是符号结构——所以它挑战了 PSSH 的必要性论断,却在行为上印证了充分性。