8.NLP自然语言处理 8.NLP自然语言处理
自然语言处理(Natural Language Processing, 简称NLP)是计算机科学与语言学中关注于计算机与人类语言间转换的领域.
文本预处理
文本预料在输送给模型前一般需要一系列的预处理工作,才能符合模型输入的要求,如:将文本转化成模型需要的张量,规范张量的尺寸等,而且科学的文本预处理环节还将有效指导模型超参数的选择,提升模型的评估指标。
分词
分词就是将连续的字序列按照一定的规范重新组合成词序列的过程。在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字、句和段能通过明显的分界符来简单划界,唯独词没有一个形式上的分界符。分词过程就是找到这样分界符的过程.
- 分词的作用:
- 词作为语言语义理解的最小单元, 是人类理解文本语言的基础. 因此也是AI解决NLP领域高阶任务, 如自动问答, 机器翻译, 文本生成的重要基础环节.
-
流行中文分词工具jieba:
-
愿景: “结巴”中文分词, 做最好的 Python 中文分词组件.
-
jieba的特性:
- 支持多种分词模式
- 精确模式
- 全模式
- 搜索引擎模式
- 支持中文繁体分词
- 支持用户自定义词典
1.文本处理的基本方法:分词、NER、POS 2.文本张量的表示方法:one-hot、word2vec、wordEmbedding 3.文本语料的数据分析:标签数量分析(类别不均衡问题)、句子长度分析、词频统计和关键词词云 4.文本特征处理:添加n-gram特征、文本长度规范 5.数据增强方法:回译数据增强
文本张量的表示方法
将一段文本使用张量进行表示,其中一般将词汇表示成向量,称作词向量,再由各个词向量按顺序组成矩阵形成文本表示.
作用: 将文本表示成张量(矩阵)形式,能够使语言文本可以作为计算机处理程序的输入,进行接下来一系列的解析工作.
One-Hot 词向量表示
针对每一个词汇,都会用一个向量表示,向量的长度是n(n就是词表大小),n代表去重之后的词汇总量,而且向量中只有0和1两种数字 也称之为:独热编码、01编码
one-hot编码的优劣势:
- 优势:操作简单,容易理解.
- 劣势:完全割裂了词与词之间的联系,而且在大语料集下,每个向量的长度过大,占据大量内存.
正因为one-hot编码明显的劣势,这种编码方式被应用的地方越来越少,取而代之的是接下来我们要学习的稠密向量的表示方法word2vec和word embedding.
Word2Vec模型
word2vec是将文本变成词向量张量的一种方法,是一种无监督(自监督)的训练方法,本质是训练一个模型,将模型的参数矩阵当作所有词汇的词向量表示。基于one-hot的形式进行优化改造
它又分为两种具体模式: - CBOW:连续词袋模式。使用两边的词预测中间的内容 - Skip-gram:跳词模式。使用中间的词预测两边的内容
Word Embedding
Word2Vec 诞生后,学术界开始疯狂研究词的表示方法。Word Embedding(词嵌入)是一个统称。Word2Vec 只是实现 Word Embedding 的一种具体算法。除此之外,还有 GloVe、FastText 等。它们的最终目的都是一样的:把词变成有语义的数字向量。
- 通过一定的方式将词汇映射到指定维度(一般是更高维度)的空间.
- 广义的word embedding包括所有密集词汇向量的表示方法,如之前学习的word2vec, 即可认为是word embedding的一种.
- 狭义的word embedding是指在神经网络中加入的embedding层, 对整个网络进行训练的同时产生的embedding矩阵(embedding层的参数), 这个embedding矩阵就是训练过程中所有输入词汇的向量表示组成的矩阵.
n-gram特征
给定一段文本序列, 其中n个词或字的相邻共现特征即n-gram特征, 常用的n-gram特征是bi-gram和tri-gram特征, 分别对应n为2和3.
RNN
传统神经网络(CNN)是金鱼脑,处理完一个词,上一个词就忘光了。
而RNN引入了隐藏状态(Hidden State)作为记忆,就像一个人在读小说,他每读下一句,都会回头看一眼上一句说了什么。
RNN(Recurrent Neural Network), 中文称作循环神经网络, 它一般以序列数据为输入, 通过网络内部的结构设计有效捕捉序列之间的关系特征, 一般也是以序列形式进行输出.
公式: 当前时刻的输出 = 当前输入 + 上一刻的记忆。
因为RNN结构能够很好利用序列之间的关系, 因此针对自然界具有连续性的输入序列, 如人类的语言, 语音等进行很好的处理, 广泛应用于NLP领域的各项任务, 如文本分类, 情感分析, 意图识别, 机器翻译等.
RNN模型示例
下面我们将以一个用户意图识别的例子进行简单的分析:
-
第一步: 用户输入了"What time is it ?", 我们首先需要对它进行基本的分词, 因为RNN是按照顺序工作的, 每次只接收一个单词进行处理.
-
第二步: 首先将单词"What"输送给RNN, 它将产生一个输出O1.
-
第三步: 继续将单词"time"输送给RNN, 但此时RNN不仅仅利用"time"来产生输出O2, 还会使用来自上一层隐层输出O1作为输入信息.
-
第四步: 重复这样的步骤, 直到处理完所有的单词.
-
第五步: 最后,将最终的隐层输出O5进行处理来解析用户意图,并识别最终意图是Asking for the time.
传统RNN的优缺点:
优点:
    内部结构简单, 资源消耗相对较小.
缺点:
    RNN的记忆是全盘接收的,如果文章长到一万字,读到结尾时,开头的主角名字早就被后来的一大堆废话冲淡、遗忘了(这叫梯度小时)
按照RNN的内部狗仔进行分类
- 传统RNN
- LSTM
- Bi-LSTM
- GRU
- Bi-GRU
LSTM
主要就是为了解决RNN记不住长句子的问题,LSTM横空出世。
LSTM是一个自带智能笔记本和红绿灯的高级秘书,它能决定什么该记,什么该忘。
LSTM(Long Short-Term Memory)也称长短时记忆结构, 它是传统RNN的变体, 与经典RNN相比能够有效捕捉长序列之间的语义关联, 缓解梯度消失或爆炸现象. 同时LSTM的结构更复杂, 它的核心结构可以分为四个部分去解析:
- 遗忘门
- 输入门
- 细胞状态
- 输出门
LSTM优势:
LSTM的门结构能够有效减缓长序列问题中可能出现的梯度消失或爆炸, 虽然并不能杜绝这种现象, 但在更长的序列问题上表现优于传统RNN.
LSTM缺点:
由于内部结构相对较复杂, 因此训练效率在同等算力下较传统RNN低很多.
GRU
LSTM虽然强大,但它的结构太复杂了,计算速度慢,像一台重型坦克。 GRU是LSTM的轻量版、极简版。
GRU(Gated Recurrent Unit)也称门控循环单元结构, 它也是传统RNN的变体, 同LSTM一样能够有效捕捉长序列之间的语义关联, 缓解梯度消失或爆炸现象. 同时它的结构和计算要比LSTM更简单, 它的核心结构可以分为两个部分去解析:
- 更新门
- 重置门
GRU的优势:
GRU和LSTM作用相同, 在捕捉长序列语义关联时, 能有效抑制梯度消失或爆炸, 效果都优于传统RNN且计算复杂度相比LSTM要小.
GRU的缺点:
GRU仍然不能完全解决梯度消失问题, 同时其作用RNN的变体, 有着RNN结构本身的一大弊端, 即不可并行计算, 这在数据量和模型体量逐步增大的未来, 是RNN发展的关键瓶颈.
注意力机制
为什么需要注意力机制?
背景: 无论是RNN还是LSTM/GRU,它们都有一个通病:试图把前面所有的信息,强行压缩成一个固定大小的记忆小球传给后面。
注意力机制的作用:打破死记硬背,学会划重点。
原理说明:人类读长文章做阅读理解时,回答第10题只会看第8段,而不会凭空记住整本书。注意力机制就是让模型学会这种本领:在生成每个词的时候,只去重点关注原文中最相关的那几个词。
seq2seq(Sequence to Sequence))架构
机器翻译(中文翻译成英文)是NLP的经典难题。输入的长度(5个中文字)和输出的长度(10个英文字母)通常是不一样的,无法直接一一对齐。
Seq2Seq(序列到序列)模型是机器翻译的雏形架构。
- seq2seq模型架构包括三部分,分别是encoder(编码器)、decoder(解码器)、中间语义张量c。
-
中文到英文的翻译:欢迎 来 北京 → welcome to BeiJing。编码器首先处理中文输入"欢迎 来 北京",通过GRU模型获得每个时间步的输出张量,最后将它们拼接成一个中间语义张量c;接着解码器将使用这个中间语义张量c以及每一个时间步的隐层张量, 逐个生成对应的翻译语言
-
Encoder(编码器):通常由 LSTM 担任。它就像一个“压缩机”,把“我爱中国”这句中文,读进去,嚼碎了,压缩成一个包含核心意思的“语义向量”(Context Vector)。
-
Decoder(解码器):它也通常由 LSTM 担任。它拿着编码器给的“语义向量”,像打字机一样,一个词一个词地往外吐出翻译后的句子“I love China”。
-
早期在解决机器翻译这一类seq2seq问题时,通常采用的做法是利用一个编码器(Encoder)和一个解码器(Decoder)构建端到端的神经网络模型,但是基于编码解码的神经网络存在两个问题:
- 问题1:如果翻译的句子很长很复杂,比如直接一篇文章输进去,模型的计算量很大,并且模型的准确率下降严重。
- 问题2:在翻译时,可能在不同的语境下,同一个词具有不同的含义,但是网络对这些词向量并没有区分度,没有考虑词与词之间的相关性,导致翻译效果比较差。
针对这样的问题,注意力机制被提出。
例如我们在看一张图片的时候,会优先注意到最新引人的东西,而图片中其他的东西在短时间内大脑不会注意到。
举例: 当我们看到下面这张图时,短时间内大脑可能只对图片中的“锦江饭店”有印象,即注意力集中在了“锦江饭店”处。短时间内,大脑可能并没有注意到锦江饭店上面有一串电话号码,下面有几个行人,后面还有“喜运来大酒家”等信息。
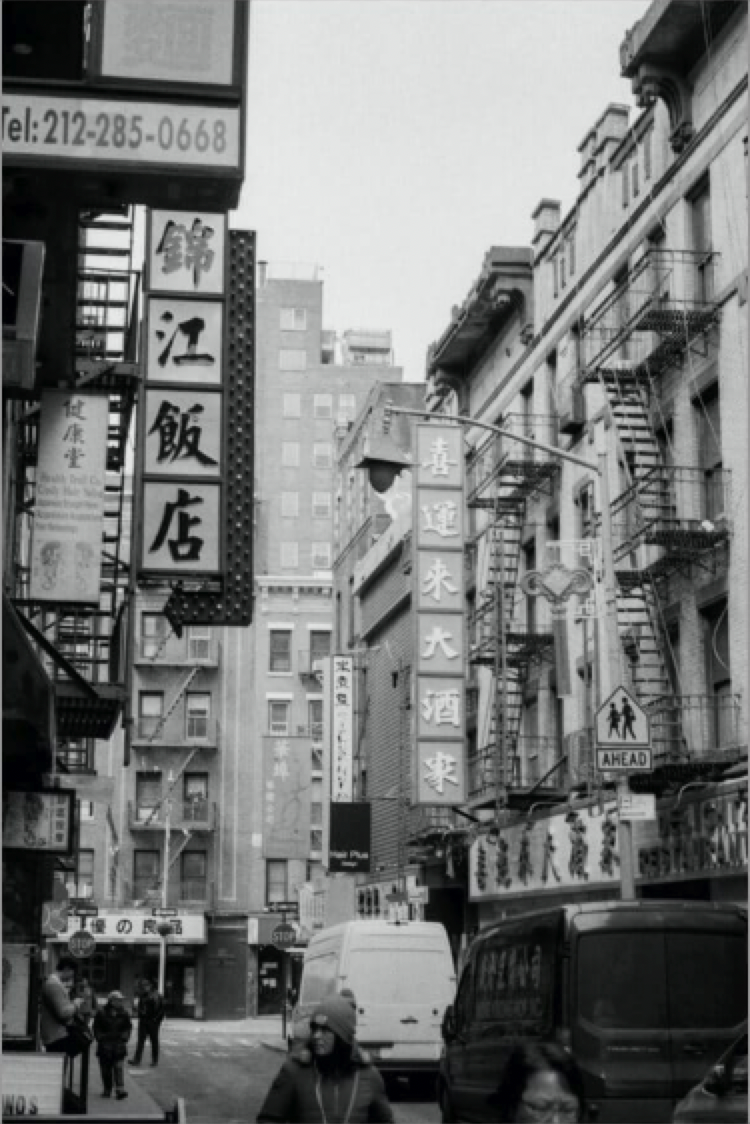
大脑在短时间内处理信息时,主要将图片中最吸引人注意力的部分读出来了,大脑注意力只关注吸引人的部分。
注意力机制分类
-
通俗来讲就是对于模型的每一个输入项,可能是图片中的不同部分,或者是语句中的某个单词分配一个权重,这个权重的大小就代表了我们希望模型对该部分一个关注程度。这样一来,通过权重大小来模拟人在处理信息的注意力的侧重,有效的提高了模型的性能,并且一定程度上降低了计算量。
-
深度学习中的注意力机制通常可分为三类: 软注意(全局注意)、硬注意(局部注意)和自注意(内注意)
-
软注意机制(Soft/Global Attention: 对每个输入项的分配的权重为0-1之间,也就是某些部分关注的多一点,某些部分关注的少一点,因为对大部分信息都有考虑,但考虑程度不一样,所以相对来说计算量比较大。
- 硬注意机制(Hard/Local Attention,[了解即可]): 对每个输入项分配的权重非0即1,和软注意不同,硬注意机制只考虑那部分需要关注,哪部分不关注,也就是直接舍弃掉一些不相关项。优势在于可以减少一定的时间和计算成本,但有可能丢失掉一些本应该注意的信息。
- 自注意力机制( Self/Intra Attention): 对每个输入项分配的权重取决于输入项之间的相互作用,即通过输入项内部的"表决"来决定应该关注哪些输入项。和前两种相比,在处理很长的输入时,具有并行计算的优势。
Attention机制的本质思想
其实Attention机制可以看作,Target中每个单词是对Source每个单词的加权求和,而权重是Source中每个单词对Target中每个单词的重要程度。因此,Attention的本质思想会表示成下图:
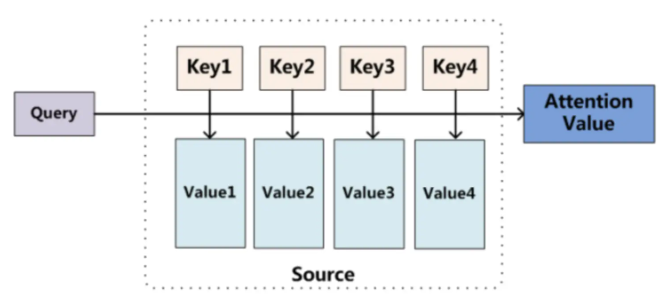
将Source中的构成元素看作是一系列的数据对,给定Target中的某个元素Query,通过计算Query和各个Key的相似性或者相关性,即权重系数;然后对Value进行加权求和,并得到最终的Attention数值。将本质思想表示成公式如下:
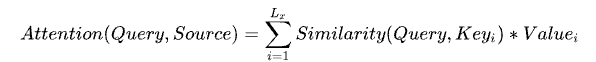
深度学习中的注意力机制中提到:Source 中的 Key 和 Value 合二为一,指向的是同一个东西,也即输入句子中每个单词对应的语义编码,所以可能不容易看出这种能够体现本质思想的结构。因此,Attention计算转换为下面3个阶段。 输入由三部分构成:Query、Key和Value。其中,(Key, Value)是具有相互关联的KV对,Query是输入的“问题”,Attention可以将Query转化为与Query最相关的向量表示。
Attention的计算主要分3步,如下图所示。
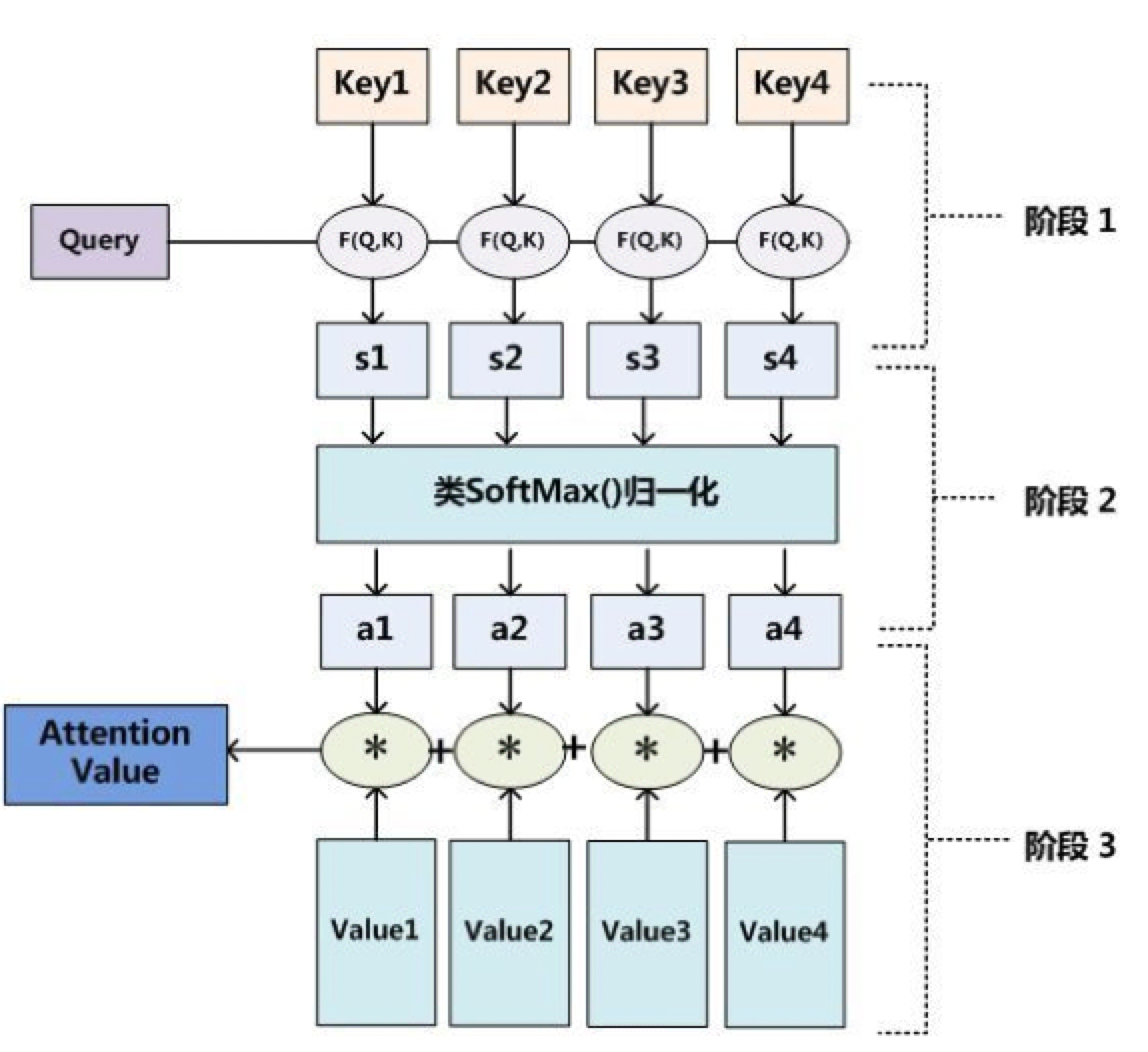
Attention 3步计算过程Attention3步计算过程:
- 第一步:Query和Key进行相似度计算,得到Attention Score;
- 第二步:对Attention Score进行Softmax归一化,得到权值矩阵;
- 第三步:权重矩阵与Value进行加权求和计算。
Query、Key和Value的含义是什么呢?
我们以刚才大脑读图为例。
- Value可以理解为人眼视网膜对整张图片信息的原始捕捉,不受“注意力”所影响。我们可以将Value理解为像素级别的信息,那么假设只要一张图片呈现在人眼面前,图片中的像素都会被视网膜捕捉到。
-Key与Value相关联,Key是图片原始信息所对应的关键性提示信息,比如“锦江饭店”部分是将图片中的原始像素信息抽象为中文文字和牌匾的提示信息。
- 一个中文读者看到这张图片时,读者大脑有意识地向图片获取信息,即发起了一次Query,Query中包含了读者的意图等信息。
在一次读图过程中,Query与Key之间计算出Attention Score,得到最具有吸引力的部分,并只对具有吸引力的Value信息进行提取,反馈到大脑中。就像上面的例子中,经过大脑的注意力机制的筛选,一次Query后,大脑只关注“锦江饭店”的牌匾部分。
再以一个搜索引擎的检索为例。
使用某个Query去搜索引擎里搜索,搜索引擎里面有好多文章,每个文章的全文可以被理解成Value;
文章的关键性信息是标题,可以将标题认为是Key。
搜索引擎用Query和那些文章们的标题(Key)进行匹配,看看相似度(计算Attention Score)。
我们想得到跟Query相关的知识,于是用这些相似度将检索的文章Value做一个加权和,那么就得到了一个新的信息,新的信息融合了相关性强的文章们,而相关性弱的文章可能被过滤掉。
Transformer模型
RNN/LSTM天生有个毛病,必须一个字一个字的按顺序读,算的慢(无法并行),而且长句子记不住。
2017年谷歌发表论文《Attention Is All You Need》,发明了 Transformer。它彻底抛弃了 RNN,只靠“注意力机制”,让机器能一眼看全整段话,并且可以同时计算所有词,速度极快。
相比之前占领市场的LSTM和GRU模型,Transformer有两个显著的优势:
1、Transformer能够利用分布式GPU进行并行训练,提升模型训练效率.
2、在分析预测更长的文本时, 捕捉间隔较长的语义关联效果更好.
原理说明: - 编码器端(Encoder):负责“阅读理解”。它由一堆相同的层组成,核心是自注意力机制(Self-Attention)。它能算出句子里“我”和“喜欢”和“苹果”之间错综复杂的关系。 - 解码器端(Decoder):负责“遣词造句”。它也由一堆层组成,但比编码器多了一层“交叉注意力(Cross-Attention)”。这层的作用是:一边看着自己已经写好的英文,一边去编码器那边“查”对应的中文意思。
Transformer总体架构图
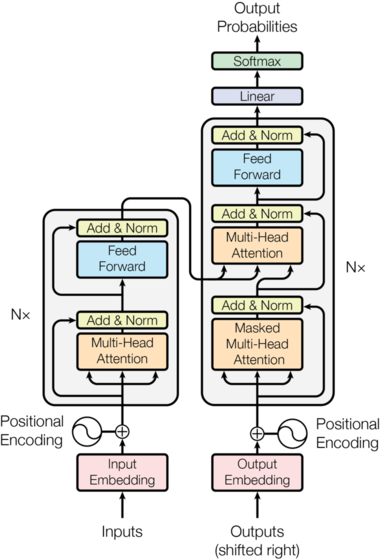
总体架构分为:
- 输入部分
- 源文本嵌入层及其位置编码器
- 目标文本嵌入层及其位置编码器
- 输出部分
- 线性层
- softmax层
- 编码器部分
- 由N个编码器层堆叠而成
- 每个编码器层由两个子层连接结构组成
- 第一个子层连接结构包括一个多头自注意力子层和规范化层以及一个残差连接
- 第二个子层连接结构包括一个前馈全连接子层和规范化层以及一个残差连接
- 解码器部分
- 由N个解码器层堆叠而成
- 每个解码器层由三个子层连接结构组成
- 第一个子层连接结构包括一个多头自注意力子层和规范化层以及一个残差连接
- 第二个子层连接结构包括一个多头注意力子层和规范化层以及一个残差连接
- 第三个子层连接结构包括一个前馈全连接子层和规范化层以及一个残差连接
多头自注意力层(Self-Attentsion)
这是Transformer最核心的创新点。
所谓的多头self-attention层,则是先将Q, K, V经过参数矩阵进行映射,再做self-attention,最后将结果拼接起来送入一个全连接层即可。
多头注意力的通俗理解就像多个专家同时分析同一个问题:
- 每个“头”(head)从不同的角度关注句子。
- 比如:头1关注语法关系,头2关注语义关联,头3关注指代关系……
- 最后把所有专家的意见汇总(拼接),再做一个综合判断(全连接层)。
为什么用多头? - 单一注意力:可能只捕捉到一种关系模式。 - 多头注意力:可以同时捕捉多种不同类型的关系,提取的特征更丰富、更细致。 - 计算量不变:多头注意力的总计算量和单头相同(因为每个头的维度缩小了),但效果更好。
NLP中常用的预训练模型
- BERT: Google出品,双向理解能力强,适合分类、问答等任务。
- GPT:OpenAI出品,单向生成能力强,适合文本生成、对话等任务。
- GPT-2
- Transformer-XL: Transformer的改进版,能处理更长的文本蓄力
- XLNet
- XLM
- RoBERTa:BERT的优化版,训练更充分,效果更好。
- DistilBERT
- ALBERT
- T5
- XLM-RoBERTa
预训练模型(Pretrained model)
文档原文:
一般情况下预训练模型都是大型模型,具备复杂的网络结构,众多的参数量,以及在足够大的数据集下进行训练而产生的模型。在NLP领域,预训练模型往往是语言模型。因为语言模型的训练是无监督的,可以获得大规模语料,同时语言模型又是许多典型NLP任务的基础,如机器翻译,文本生成,阅读理解等,常见的预训练模型有BERT, GPT, roBERTa, transformer-XL等。
我的讲解:
背景:在深度学习早期,人们做任何一个NLP任务(比如情感分析、文本分类)都需要从零开始训练一个模型。这需要: 大量的标注数据(比如几万条人工标注的情感数据) 大量的计算资源(GPU跑几天甚至几周) 大量的时间 但现实是,很多场景下我们没有那么多标注数据,也没有那么多算力。
预训练模型的出现解决了这个问题:
通俗理解:预训练模型就像一个“通才大学生”。他花了四年时间(预训练阶段)学习了广泛的通识知识(海量语料),比如语言、历史、科学等。虽然他还没有专门学习过“如何做情感分析”这门课,但他已经具备了很强的语言理解能力。
预训练模型的特点: 规模大:参数量通常在几亿到几千亿之间(比如BERT有3.4亿参数,GPT-3有1750亿参数)。 训练数据大:通常在几十GB甚至TB级别的文本数据上训练(比如整个维基百科、书籍语料库)。 训练时间长:在数百块GPU上训练数周甚至数月。 通用性强:学到的语言知识可以迁移到各种下游任务中。 为什么预训练模型通常是语言模型? 语言模型的训练是无监督的(不需要人工标注),只需要大量的原始文本即可。 语言模型本身就是NLP的基础能力(理解词、句、篇章),可以作为其他任务的基础。 常见的预训练模型: BERT:Google出品,双向理解能力强,适合分类、问答等任务。 GPT:OpenAI出品,单向生成能力强,适合文本生成、对话等任务。 roBERTa:BERT的优化版,训练更充分,效果更好。 transformer-XL:Transformer的改进版,能处理更长的文本序列。 文档中没有明说但很重要的点: 预训练模型通常由大公司或研究机构训练并开源(免费提供),普通人可以直接下载使用。 预训练模型的训练成本极高(GPT-3的训练成本估计在千万美元级别),但使用成本很低(下载到本地或调用API即可)。
微调(Fine-tuning)
文档原文:
根据给定的预训练模型,改变它的部分参数或者为其新增部分输出结构后,通过在小部分数据集上训练,来使整个模型更好的适应特定任务。
我的讲解:
背景:预训练模型虽然是“通才”,但它并不精通某个特定任务。比如,BERT虽然懂语言,但如果你直接问它“这部电影是好评还是差评?”,它不知道怎么回答。因为它的“脑袋”(输出层)是设计来做语言理解的,而不是做分类的。
微调就是解决这个问题的:
通俗理解:微调就像“通才大学生参加岗前培训”。这位大学生(预训练模型)已经具备了扎实的通识基础,现在他要去做“情感分析”这个具体岗位的工作。他只需要: 换一个“岗位帽子”(更换或新增输出层,比如把原来的语言模型头部换成分类器头部)。 用少量的岗位培训资料(小部分标注数据,比如1000条情感标注数据)进行短期培训(训练)。 培训过程中,他不需要重新学习语言知识,只需要微调自己的“思维方式”(更新小部分参数)来适应新岗位。 微调的关键点: 改变部分参数:通常不是重新训练整个模型,而是只更新最后几层或部分层的参数。前面的层(负责基础语言理解)保持不动或只做微小调整。 新增输出结构:预训练模型的输出层通常是语言模型的输出(预测下一个词),但具体任务可能需要分类器、序列标注器等不同的输出结构。微调时需要替换或新增这些结构。 小部分数据集:微调只需要少量标注数据(几百到几万条),远少于从零训练所需的数据量。 训练时间短:微调通常在几小时到几天内完成,远少于预训练的数周。 微调的优势: 省数据:不需要大量标注数据。 省算力:不需要昂贵的GPU集群。 省时间:训练速度快。 效果好:预训练模型已经学到了丰富的语言知识,微调后通常比从零训练的模型效果更好。
微调不等于重新训练:微调通常只更新模型参数的1%~10%,而不是全部。如果全部更新,就失去了迁移学习的意义(相当于从零训练)。 学习率要小:微调时通常使用很小的学习率(如2e-5),因为预训练模型已经很好,只需要做微小调整,太大的学习率会破坏已有的知识。 灾难性遗忘:如果微调时学习率太大或数据太少,模型可能会“忘记”预训练时学到的知识,导致效果变差。这是微调中需要特别注意的问题。
Huggingface
Huggingface总部位于纽约,是一家专注于自然语言处理、人工智能和分布式系统的创业公司。他们所提供的聊天机器人技术一直颇受欢迎,但更出名的是他们在NLP开源社区上的贡献。Huggingface一直致力于自然语言处理NLP技术的平民化(democratize),希望每个人都能用上最先进(SOTA, state-of-the-art)的NLP技术,而非困窘于训练资源的匮乏。同时Hugging Face专注于NLP技术,拥有大型的开源社区。尤其是在github上开源的自然语言处理,预训练模型库 Transformers,已被下载超过一百万次,github上超过24000个star。
框架支持了最新的各种NLP预训练语言模型,使用者可快速的进行模型调用,并且支持模型further pretraining 和 下游任务fine-tuning。举个例子Transformers 库提供了很多SOTA的预训练模型,比如BERT, GPT-2, RoBERTa, XLM, DistilBert, XLNet, CTRL。
Huggingface Transformers 是基于一个开源基于 transformer 模型结构提供的预训练语言库。它支持 Pytorch,Tensorflow2.0,并且支持两个框架的相互转换。Transformers 提供了NLP领域大量state-of-art的 预训练语言模型结构的模型和调用框架。
HuggingFace这家公司(现在是全球最大的NLP开源社区)开发了一个叫Transformers的Python库,它把所有的预训练模型都封装成了统一的API。你只需要: - 知道模型的名字(比如bert-base-chinese)。 - 调用from_pretrained()方法。 - 模型就自动下载并加载到内存中了。
通俗理解:Transformers库就像是一个“模型超市”。你走进超市,告诉店员“我要买BERT中文版”,店员就会从货架上拿给你(自动下载),而且已经帮你拆好包装、摆上桌了(加载到内存)。你不需要自己去生产这个商品(实现模型结构)。
BERT模型
BERT(Bidirectional Encoder Representations from Transformers)是2018年由Google提出的。它的核心思想是:用Transformer的编码器(Encoder)训练一个双向语言模型,通过“完形填空”和“下一句预测”两个任务来学习深层语义。
通俗理解:BERT像一个阅读理解高手,它能同时看句子的前后文,理解每个词在上下文中的准确含义。它不会生成文本,而是擅长理解文本。
特点: - 双向(Bidirectional):同时看到左右上下文,理解更准确。 - 理解能力强:在分类、问答、命名实体识别等理解型任务上表现卓越。 - 预训练+微调范式:成为后续所有预训练模型的标准范式。
应用场景: 文本理解、分类、问答
GPT
GPT(Generative Pre-training Transformer)是2018年由OpenAI提出的。它的核心思想是:用Transformer的解码器(Decoder)训练一个单向语言模型,然后通过微调适配各种下游任务。
通俗理解:GPT像一个写作高手,它只能从左到右看文本,预测下一个词是什么。它不会回头看后面的词,所以特别擅长生成任务(写文章、续写故事)。 特点: - 单向(自左向右):只能看到当前词之前的上下文,不能看到后面的词。 - 生成能力强:非常适合文本生成、对话系统等任务。 - 统一架构:GPT证明了同一个模型可以通过微调解决多种NLP任务(分类、推理、问答等)。
应用场景:文本生成、对话
ELMo模型
ELMo(Embeddings from Language Models)是2018年由Allen AI研究所提出的。它的核心思想是:用双向LSTM训练语言模型,然后提取每一层的隐藏状态作为词向量。
通俗理解:ELMo像一个阅读高手,在读一句话时,它会从左到右读一遍(正向LSTM),再从右到左读一遍(反向LSTM),然后把两个方向的信息融合起来,给每个词生成一个动态的、包含上下文信息的向量。
特点:
- 动态性:同一个词在不同句子中会有不同的向量。
- 浅层融合:ELMo只是把预训练模型的输出作为特征,不修改模型本身(特征提取方式)。
- 基于LSTM:受限于LSTM的序列处理能力,长距离依赖仍然有困难。
应用场景:特征增强、序列标准
关键区别总结:
- ELMo:用LSTM做双向语言模型,提取动态特征,但不修改模型本身(特征提取型)。
- GPT:用Transformer解码器做单向语言模型,预训练后通过微调适配任务(生成型)。
- BERT:用Transformer编码器做双向语言模型,通过MLM+NSP预训练,微调适配任务(理解型)。
BERT和LLM
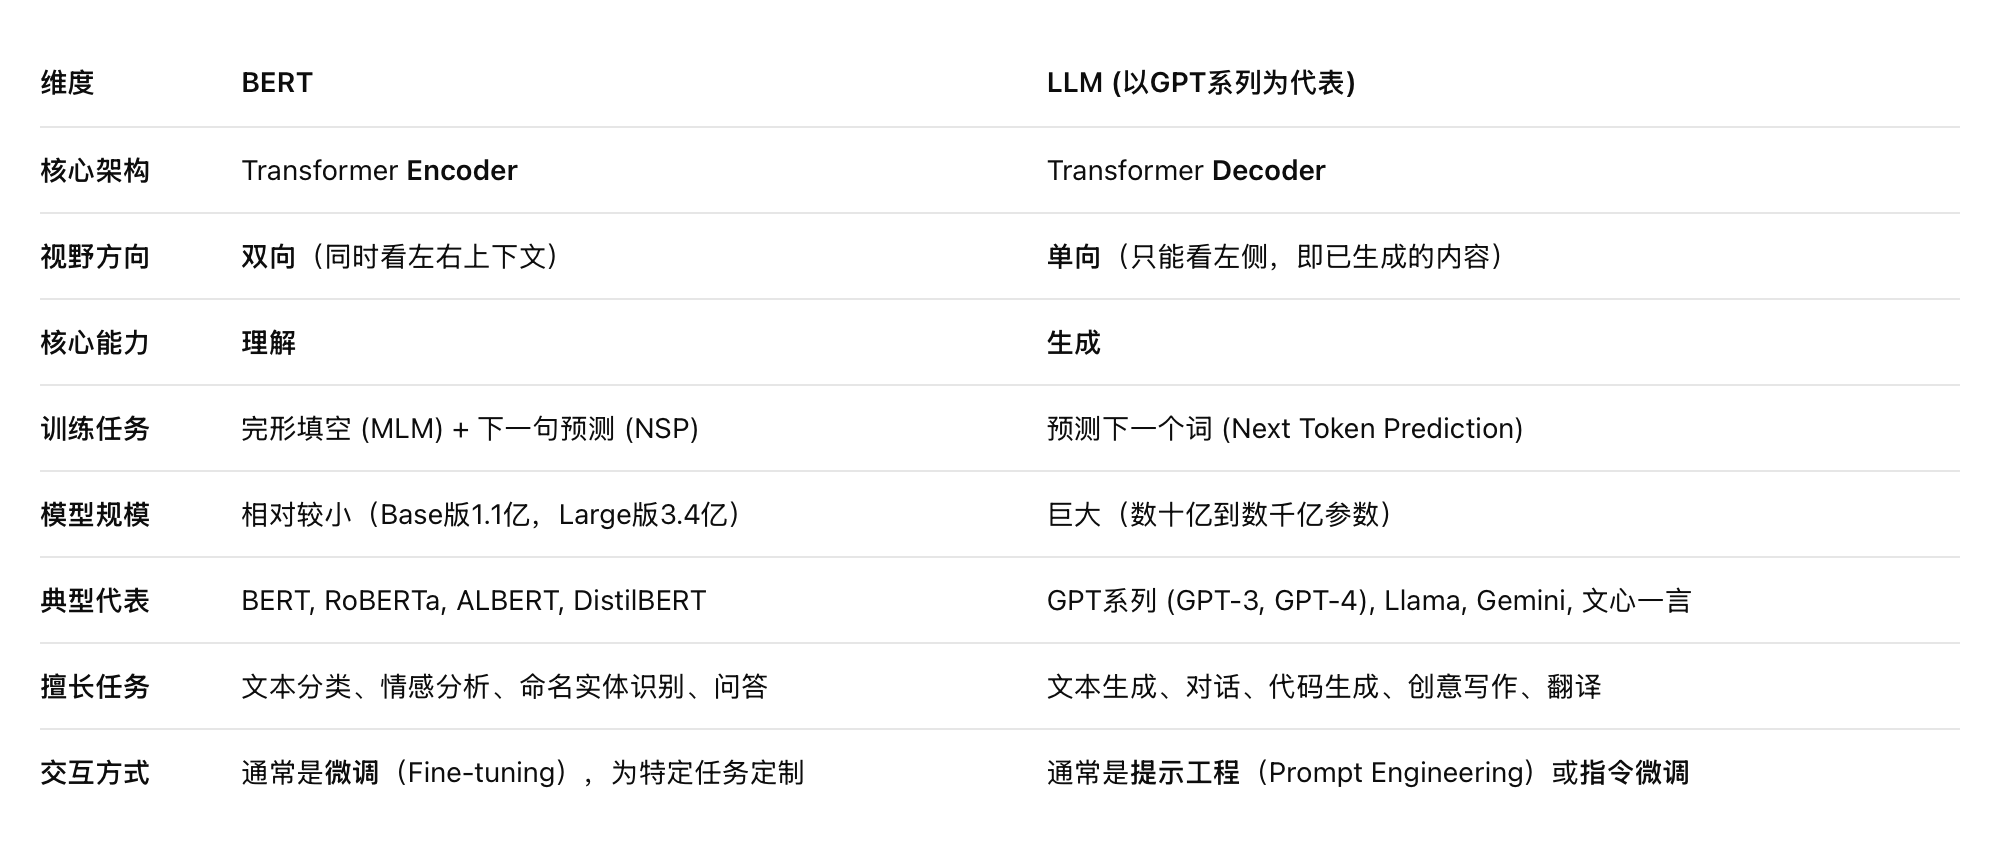
一个关键的比喻: - BERT 像一台高精度的扫描仪,能把文档里的每个字、每句话都分析得清清楚楚。 - LLM (GPT) 像一台智能打印机,你告诉它要打印什么内容,它就能源源不断地创造出来。
技术路线:
- Bert模型: 传统微调路线,下载BERT预训练模型,在自己的数据上微调,训练一个分类模型
- LLM:大规模API路线,调用DeepSeek大模型的API,通过提示词直接让大模型分类,无需训练。
BERT与LLM的关系
它们不是对立关系,而是继承与发展的关系。
- 技术奠基者:BERT是预训练语言模型时代的里程碑。它证明了“大规模预训练 + 任务微调”这个范式的巨大成功,为后来的LLM铺平了道路。可以说,没有BERT的成功,就不会有后来GPT-3、ChatGPT的爆发。
- 架构分化:BERT成功后,业界分成了两条技术路线:
- BERT路线:专注于理解,继续优化Encoder架构(如RoBERTa、ALBERT)。
- GPT路线:专注于生成,坚定地走Decoder-only路线,并不断扩大模型规模,最终催生了今天的LLM浪潮。
- 能力互补:在很多实际应用中,BERT和LLM可以协同工作。
- BERT做“粗活”:用一个小巧的BERT模型快速完成意图识别、实体抽取等预处理任务,速度快、成本低。
- LLM做“细活”:把BERT处理好的结构化信息交给LLM,让LLM进行深度的推理、总结和生成。
- BERT的地位:虽然现在LLM风头正盛,但BERT并没有过时。在许多对延迟敏感、计算资源有限、任务明确的场景下(如手机端的文本分类、搜索引擎的片段匹配),一个微调好的BERT模型依然是性价比极高的选择。
总结
- BERT 是一个具体的、以理解为核心的预训练模型,是前LLM时代的王者。
- LLM 是一类以生成为核心的大规模模型,是当前AI时代的主角。
- 关系:BERT是LLM的重要技术先驱,它们基于相同的Transformer根基,但走向了不同的应用方向。今天,你可以把它们看作是AI工具箱里两把不同功能的利器,根据具体任务来选择使用哪一把。