机器学习
ML(Machine Learning): 简单说就是从数据中获取规律,来了一个新的数据,产生一个新的预测。
主要研究计算机系统对于特定任务的性能,逐步进行改善的算法和统计模型。通过输入海量训练数据对模型进行训练,使模型掌握 数据所蕴含的潜在规律,进而对新输入的数据进行准确的分类或预测。
提到机器学习,追根溯源,我们需要先知道什么是“学习”。著名学者、1975年图灵奖获得者、1978年诺贝尔经济学奖获得者,赫伯特·西蒙(Herbert Simon)教授曾对“学习”下过一个定义:
如果一个系统,能够通过执行某个过程,就此改进它的性能,那么这个过程就是学习。
在西蒙看来,学习的核心目的就是改善性能。
其实对于人而言,这个定义也是适用的。如果我们仅仅进行低层次的重复性学习,而没有达到认知升级的目的,那么即使表面看起来非常勤奋,其实也仅仅是一个“伪学习者”,因为我们的性能并没有得到改善。
西蒙认为,对于计算机系统而言,通过运用数据及某种特定的方法(比如统计方法或推理方法)来提升机器系统的性能,就是机器学习(Machine Learning,简称ML)。
人工智能、机器学习和深度学习
人工智能(AI)是计算机科学的一个广泛领域,目标是让机器具备类人的“智能”,包括自然语言处理(NLP)、计算机视觉、机器人技术、专家系统等等;具体实现手段多种多样,包括规则系统、符号逻辑、统计方法、机器学习等。 机器学习是AI的一个子领域,核心是通过数据驱动,让计算机进行学习并改进性能,自动发现规律(模式),并利用这些规律进行预测或决策。 深度学习是机器学习的一个子领域,基于多层神经网络处理复杂任务。

所谓机器学习,在形式上可近似等同于,在数据对象中通过统计或推理的方法,寻找一个有关特定输入和预期输出的功能函数f
- 数据集(Data Set): 多条记录的集合
- 训练集(Training Set): 用于训练模型的数据
- 验证集(Validation Set): 用于调节超参数的数据
- 测试机(Test Set): 用于评估模型性能的数据
- 样本(sample): 数据集中的一条记录是关于一个事件或对象的描述,称为一个样本。一行数据就是一个样本,多个样本组成数据集,有时一条样本也被叫做一条记录
- 特征(feature): 数据集中一列反应事件或对象在某方面的表现或性质的事项,成为特征,一列数据一个特征,有时也被称为属性,例如房子的位置、房子的面积
- 特征向量(Feature Vector): 将样本的所有特征表示为向量的形式,输入到模型中
- 标签(lable): 监督学习中每个样本的结果信息,也称作目标值(target)。模型要预测的那一列数据,例如房价
- 参数(Parameter): 模型通过训练学习到的值,例如线性回归中的权重和偏置。
- 超参数(Hyper Parameter): 由用户设置的参数,不能通过训练自动学习,例如学习率、正则化系数等。
机器学习算法分类
监督学习(Supervised Learing)
监督学习: 输入数据是由输入特征值和目标值所组成,即输入的训练数据是有标签的。
- 监督学习 (Supervised Learning):“有标准答案”。
- 你给模型看带有标签的数据(比如:这张图是猫,那句话是骂人),让它学会规律。
- 代表:线性回归、逻辑回归、决策树、KNN、支持向量机 (SVM)。
所有的监督学习(Supervised Learning),基本上都是分类(Classification)的代名词。
它从有标签的训练数据中学习模型,然后对某个给定的新数据利用模型预测它的标签。
比如,小时候父母告诉我们某个动物是猫、狗或猪,然后在我们的大脑里就会形成或猫或狗或猪的印象(相当于模型构建),当面前来了一只“新”小狗时,如果你能叫出“这是一只小狗”,那么恭喜你,标签分类成功!
但如果你回答说“这是一头小猪”,这时你的父母就会纠正你的偏差:“乖,不对,这是一只小狗。”这样一来二去地进行训练,不断更新你大脑的认知体系,当下次再遇到这类新的猫、狗、猪时,你就会在很大概率上做出正确的“预测”分类。
监督学习,就是先利用有标签的训练数据学习得到一个模型,然后使用这个模型对新样本进行预测。在本质上,监督学习的目标在于,构建一个由输入到输出的映射,该映射用模型来表示。
无监督学习(Unsupervised Learning)
无监督学习:输入数据没有被标记,即样本数据类别位置,没有标签,根据样本间的相似性,对样本集聚类,以发现事物内部结构及相互关系
也就是说没有标准答案。
- 你扔一堆杂乱无章的数据给它,让它自己找规律分组。
- 代表:K-Means 聚类、PCA 降维。
强化学习(Reinforcement Learning)
强化学习: 输入动态的数据,决策+回报函数(每个状态目标值是变化的)。目的是能获得更多奖励,进行一系列决策过程。
类比就是打游戏。
模型通过不断试错获得奖励或惩罚来学习(比如AlphaGo).
半监督学习
- 半监督学习:部分样本有目标值,部分数据无目标值。
机器学习建模流程
- 获取数据
- 数据基本处理
- 特征工程(特征提取、特征预处理、特征降维、特征选择、特征组合)
- 机器学习(模型训练)
- 模型评估
拟合
用在机器学习领域,用来表示模型对样本点的拟合情况。
- 拟合(fitting)
- 欠拟合(under-fitting): 模型在训练集上表现很差,在测试集表现也很差
- 过拟合(over-fitting):模型在训练集上表现很好,在测试集表现很差
K近邻(KNN)核心思想
通俗解释:物以类聚,人以群分
如果你想找张三这个人,不用翻遍全城,只要找到他朋友圈里最常聚会的那几个人(邻居),他们大概率就是张三的朋友。
- 核心逻辑:计算新数据点与已知数据点之间的距离,找出最近的K个点,这K个点里哪个类别多,新数据点就属于哪一类。
距离度量方式
- 欧氏距离(Euclidean Distance): 直线距离,最常用
- 曼哈顿距离(Manhattan Distance): 街区距离
归一化和标准化
-
为什么要做?
- KNN算距离时,如果一个特征值很大(比如工资几万),另一个很小(比如年龄几十),算出来的距离会被工资主导,年龄就不起作用了,这就好比比较人和大象的体重来决定谁跑的快,显然不合理。
-
归一化(Normalization): 把数据压缩到[0, 1]之间,适合图像处理。
- 标准化(Standardization): 把数据调整为均值为0,方差为1.适合大多数其他场景(如逻辑回归)。
线性回归(Linear Regression)
通俗解释:画一条最合适的直线。
问题:你想预测一个连续的值,比如房价、温度、股票价格。
例子:你手里有几套房子的数据:面积(平方米)和成交价(万元)。你想知道:如果我有120平米的房子,能卖多少钱?
线性回归做的事:
它认为“面积”和“价格”之间可能存在一个近似直线的关系:
价格 = w × 面积 + b
其中 w 是斜率(每平米多少钱),b 是基础价(比如地段价值)。
它的任务是:找到一组最好的 w 和 b,让这条直线尽可能靠近你已知的那些数据点(面积-价格散点图)。
总结:线性回归是用来“拟合一条直线”,从而预测连续数值的。
- 损失函数(Loss Function): 衡量画的准不准
- 通常用MSE(均方误差):预测值和真实值的差的平方的平均值,越小越好。
上面说到线性回归的任务是:找到一组最好的 w 和 b,让这条直线尽可能靠近你已知的那些数据点(面积-价格散点图)。
但是怎么着呢?
找最优值的方法
- 正规方程(Normal Equation): 数学公式秒杀
- 直接套用数学公式算出最有参数。缺点:数据量大时会算的很慢,且不一定有逆矩阵。
梯度下降就是一个自动寻找最佳参数的数学方法。
想象你是一个盲人,站在一座山上(这座山的高度代表预测误差),你的目标是走到山谷(误差最小的地方)。
- 你看不见,只能用脚探一探哪个方向是下坡(计算梯度,即误差函数对参数的导数方向)。
- 然后朝那个方向走一小步(更新参数: w = w - 学习率 * 梯度)
-
重复这个过程,直到你感觉脚下已经很平坦了(梯度接近0),说明你到了山谷(找到了最佳参数)。
-
梯度下降(Gradient Descent) :盲人下山
- 原理: 不看全局,只看脚下的坡度,沿着坡度最陡的下坡方向(负梯度)一步步走,知道走到谷底(误差最小)
- 学习率(Learning Rate): 步子大小,步子太大容易跨国谷底摔死,步子太小走的太慢。
为什么需要梯度下降
因为很多模型(比如神经网络)的参数成千上万,不可能用手算或穷举,梯度下降是最通用的优化方法,几乎所有的机器学习模型都用它来训练。
总结:梯度下降是用来“自动调整参数,让模型预测误差越来越小”的优化工具。
梯度下降的三大分类
- 批量梯度下降 (BGD):每次走一步都要看遍全山(所有数据)。稳,但慢。
- 随机梯度下降 (SGD):闭着眼睛随便扔一步(只看一个数据)。快,但晃来晃去不稳定。
- 小批量梯度下降 (MBGD):最常用。每次扔几步(看一小批 Batch 数据)。兼顾了速度和稳定性。
逻辑回归的核心思想
问题: 线性回归只能预测连续值(比如房价),但是如果我想做分类呢? 比如判断一封邮件是不是垃圾邮件(是/否),或者判断图片里是不是猫(是/否)。
逻辑回归就是用来做二分类的。
它是怎么做的?
- 它先像线性回归一样,算出一个分数 z = w * 特征 + b。
- 但这个分数可以是负数或大于1,不能直接当概率用
- 所有它把z扔进一个叫Sigmoid的S形函数,输出一个结余0和1之间的数,这个数就是属于类别1的概率
- 如果概率 > 0.5,就判定为类别1(比如垃圾邮件),否则为类别0.
总结:逻辑回归是用来做二分类的,输出的是一个概率值。
逻辑回归的底层优化
虽然叫回归,但它其实是分类算法。它依然使用梯度下降来找最优参数,只不过代价函数变成了交叉熵损失 (Cross-Entropy Loss)。
模型评估
损失函数
对于模型一次预测结果的好坏,需要有一个度量标准。
对监督学习而言,给定一个输入X,选取的模型就相当于一个“决策函数f”,它可以输出一个预测结果f(X),而
真实的结果(标签)记为Y。
f(X)和Y之间可能会有偏差,我们就用一个损失函数(loss function)来度量预测偏差的程度,记作L(Y, f(X)).
- 损失函数用来衡量模型预测误差的大小,损失函数值越小,模型就越好。
- 损失函数是f(X)和Y的非负实值函数。
常见的损失函数有:
- O-1损失函数
- 平方损失函数
- 绝对损失函数
- 对数似然损失函数
正则化
正则化(Regularization)是一种在训练机器学习模型时,在损失函数中添加额外项,来惩罚过大的参数,进而
限制模型复杂度,避免过拟合,提高模型泛化能力的技术。
正则化系数不属于模型的参数,无法通过训练学习得到,需要在模型训练开始之前手动设置,这种参数被称为“超参数”
模型求解算法
正则化可以有效防止过拟合,增强模型的泛化能力。这时模型的评估策略,就是让结构化的经验风险最小,即增加了正则化项的损失函数最小,称为 结构风险最小化(Structural Risk Minimization,SRM)。
这其实就是求解一个最优化问题。
具体的求解算法,可以利用数学公式直接计算解析也可以使用迭代算法。
- 解析法: 如果模型损失函数的最小值可以通过数学公式进行严格推导,得到一个解析解,那么就直接得到了最优模型的全部参数,这种方法称作解析法。
- 线性回归问题: 可以采用最小二乘法求得解析值
-
梯度下降法 梯度下降法(gradient descent)是一种常用的一阶优化方法,是求解无约束优化问题最简单、最经典的方法之一。梯度下降法是迭代算法,基本思路就是先选取一个适当的初始值θ0,然后沿着梯度方向或者负梯度方向,不停地更新参数,最终取到极小值。
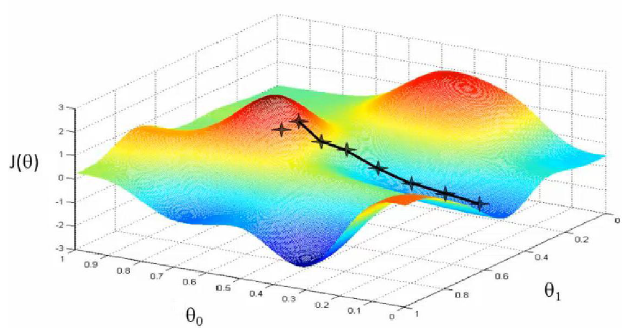
梯度方向:函数变化增长最快的方向(变量沿此方向变化时函数增长最快)
负梯度方向:函数变化减少最快的方向(变量沿此方向变化时函数减少最快)
因为损失函数是系数的函数,那么如果系数沿着损失函数的负梯度方向变化,此时损失函数减少最快,能够以最快速度下降到极小值。θk+1=θk− α·▽L(θk)
- 这里的▽Lθk是参数取值为 θk 时损失函数 L 的梯度;
- α 是每次迭代的“步长”,被称为“学习率”。
- 学习率也是一个常见的超参数,需要手动设置,选择不当会导致收敛失败。
简单总结:
-
线性回归是用来预测连续的数字的:w 是权重(斜率),b 是偏置(截距)。模型要做的就是找到一组最好的 w 和 b,使得这条直线尽量贴合已有的数据点。
-
逻辑回归是用来做二分类的,也就是判断是或者不是的,它在线性回归的基础上,加了一个挤压函数(Sigmoid函数),把任意 实数输出压缩到0和1之间,变成一个概率。
无论是线性回归还是逻辑回归,都需要找到一组最佳的w和b,使得预测误差最小。梯度下降就是一种自动寻找最佳参数的数学方法。
模型评价指标
对学习的泛化性能进行评估,不仅需要有效可行的实验估计方法,还需要有衡量模型泛化能力的评价指标,也叫做性能度量(performance measure)。
主要分为回归模型评价指标和分类评价指标
回归模型评价指标
模型的评价指标用于衡量模型在训练集或测试集上的性能,评估结果反映了模型预测的准确性和泛化能力。 对于回归问题,最常用的性能度量是“均方误差” (Mean Squared Error,MSE)。
分类模型评级指标
对于分类问题,最常用的指标就是准确率(Accuracy),它定义为分类器对测试集正确分类的样本数和总样本数纸之比。
混淆矩阵
混淆矩阵(Confusion Matrix)是用于评估分类模型性能的工具,展示了模型预测结果与实际标签的对比情况。 对于二分类问题,混淆矩阵是一个2×2矩阵:
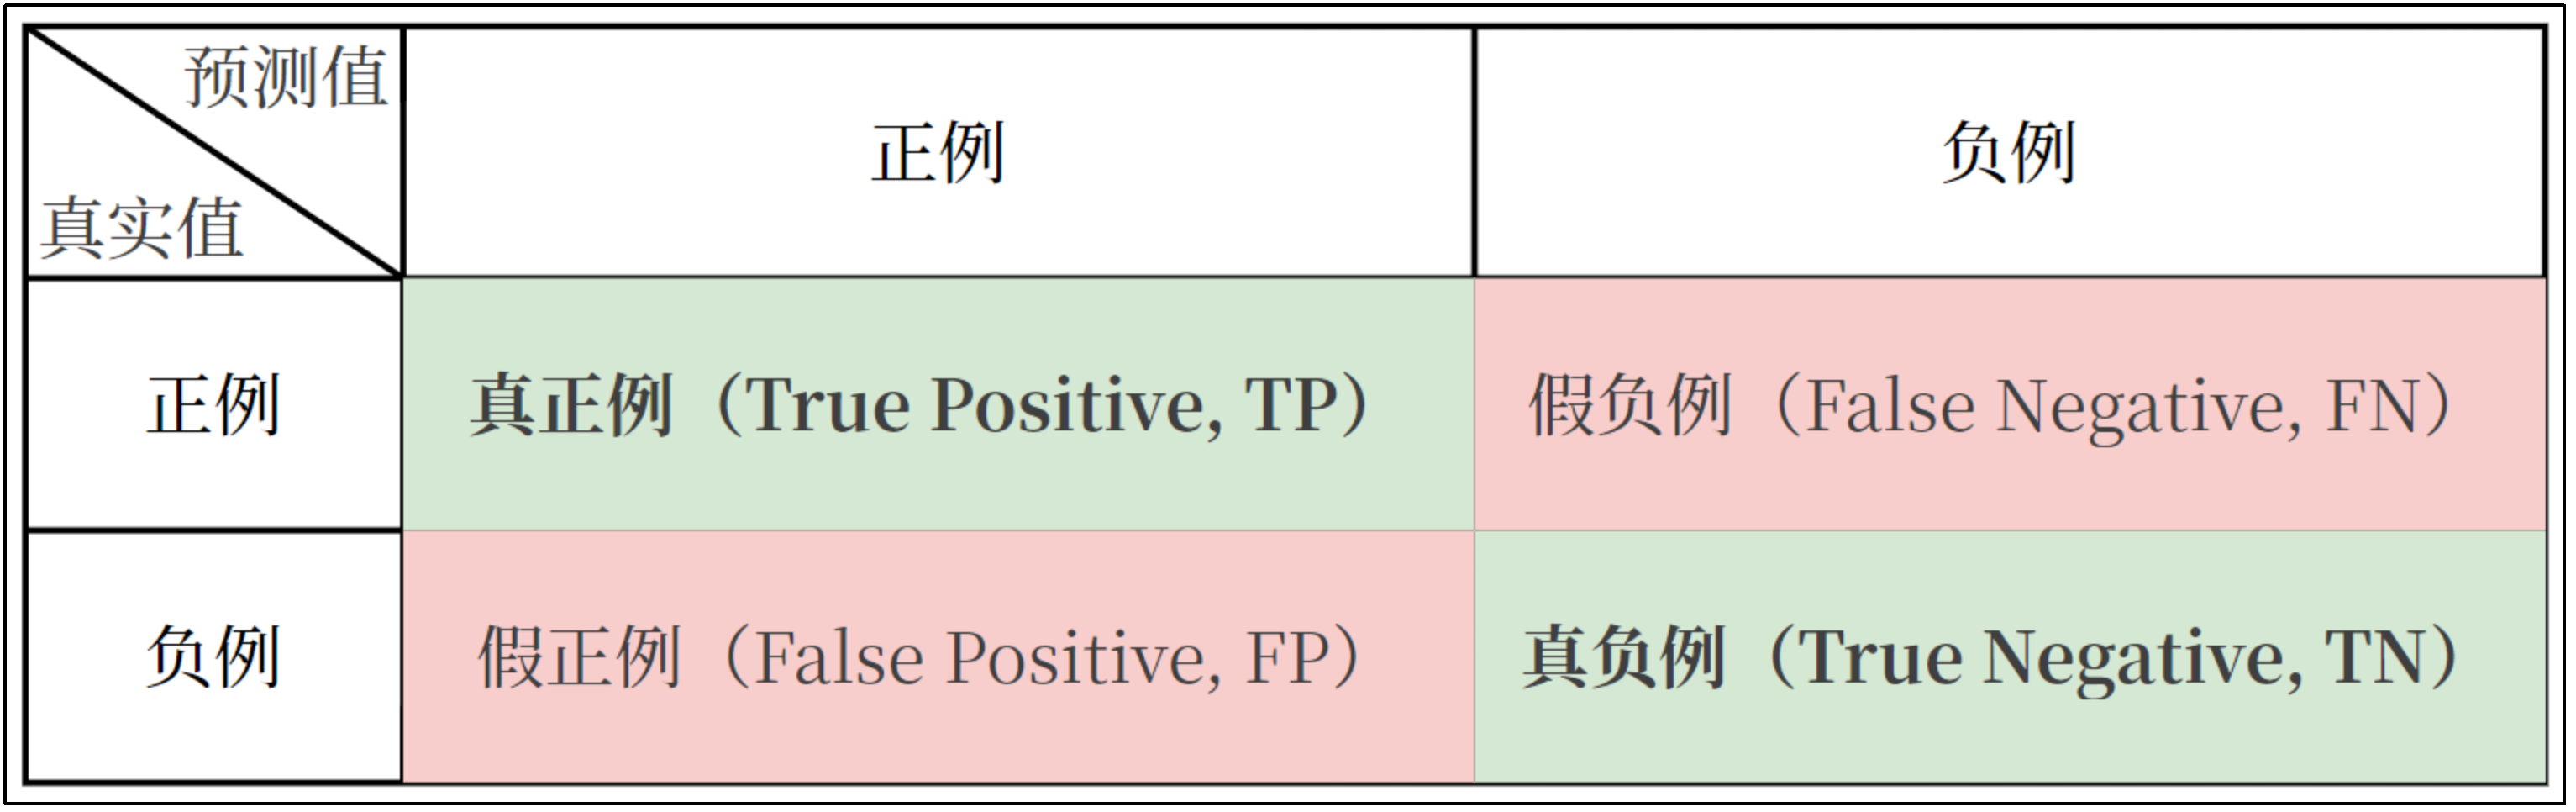
假设我们在做一个“癌症筛查”模型,测试了 100 个病人: - TP (True Positive):真正例, 真有病,模型也查出来了。 - FP (False Positive):假正例,没病,模型误报有病。 - TN (True Negative):真反例,没病,模型也没查出来。 - FN (False Negative):假反例,真有病,模型漏掉了(漏诊)。
计算公式: - 准确率 (Accuracy) = (TP + TN) / 总数 - 通俗:整体上看,模型猜对的比率。但在样本不平衡时(比如癌症患者只占1%)会误导人。 - 精确率 (Precision) = TP / (TP + FP) - 通俗:医生说你有病,你真的有病的概率有多大?(关心的是:判定的准不准,怕冤枉好人)。 - 召回率 (Recall) = TP / (TP + FN) - 通俗:所有真正有病的人里,医生找出来了多少?(关心的是:有没有漏网之鱼,怕放过坏人)。 F1 分数:精确率和召回率的调和平均数,两者都高 F1 才高。当你既不想误诊太多,也不想漏诊太多时就用F1。
KNN算法
K近邻算法(K-Nearest Neighbors,KNN)是一种基本的分类与回归方法,属于监督学习算法。其核心思想是通过计算给定样本与数据集中所有样本的距离,找到距离最近的K个样本,然后根据这K个样本的类别或值来预测当前样本的类别或值。
线性回归
线性回归(Linear Regression)是一种用于建模两个或多个变量之间线性关系的统计方法。它通过拟合一条直线(或超平面)来描述自变量(输入特征)与因变量(输出目标)之间的关联,并可用于预测或分析变量间的影响关系。 假设因变量y与自变量x1,x2,…,xn之间的关系可以用如下线性方程表示: y=β0+β1x1+β2x2+…+βnxn
β0:截距,模型在自变量全为0时的基准值 β1,β2,…,βn:自变量的系数,表示每个自变量对因变量的影响程度 通过估计这些系数,使模型预测值尽可能接近真实值。
逻辑回归
逻辑回归(Logistic Regression)是一种用于解决分类问题的统计方法,尤其适用于二分类问题。尽管名称中有“回归”,但它主要用于分类任务。 逻辑回归通过将线性回归的输出映射到[0,1]区间,来表示某个类别的概率。 常用的映射函数是sigmoid函数
逻辑回归常用场景:
信用评分:预测客户是否会违约(违约/不违约)。
欺诈检测:预测某笔交易是否是欺诈行为。
垃圾邮件检测:预测一封邮件是否是垃圾邮件(垃圾邮件/非垃圾邮件)。
广告点击预测:预测用户是否会点击某个广告(点击/不点击)。
图像分类:将图像分类为不同的类别(如猫、狗、鸟等)。
情感分析:将文本分类为正面、负面或中性情感。
产品质量分类:预测产品是否合格。
医学诊断:预测患者是否患有某种疾病(患病/未患病)。
蛋白质功能预测:基于蛋白质序列和结构特征预测其功能类别。
逻辑回归通常用于二分类问题,但可以通过一对多(One-vs-Rest,OvR)以及Softmax回归(Multinomial Logistic Regression,多项逻辑回归)来扩展到多分类任务。
逻辑回归的损失函数通常使用对数损失(Log Loss),也称为二元交叉熵损失(Binary Cross-Entropy Loss),用于衡量模型输出的概率分布与真实标签之间的差距。逻
Softmax回归(多项逻辑回归)
直接扩展逻辑回归到多分类问题,使用Softmax函数将模型输出转化为概率分布。