7.深度学习
传统机器学习算法依赖人工设计特征,并进行特征提取。
而深度学习方法不需要人工,而是依赖算法自动提取特征。
深度学习通过模仿人脑的神经网络来处理和分析复杂的数据,从大量数据中自动提取复杂特征。 这也是深度学习被看做黑盒子,可解释性差的原因。
深度学习作为机器学习的一个分支,专注于使用多层神经网络(深度神经网络)来建模和解决问题。 人脑中有很多相互连接的神经元,当大脑处理信息时,这些神经元之间通过电信号和化学物质相互作用,在大脑的不同区域之间传递信息。神经网络使用人工神经元模仿这种生物现象,这些人工神经元由称为节点的软件模块构成,使用数值计算来进行通信和传递信息。
深度学习尤其擅长处理高维数据,如图像、语音和文本。
神经网络的构成
在生物体中,神经元 是神经系统最基本的结构和功能单位。 神经元从树突接收其它神经元细胞发出的电化学刺激脉冲,这些脉冲叠加后,一旦强度达到临界值,这个神经元就会产生动作电位,沿着轴突发送电信号。 轴突将刺激传到末端的突触,电信号触发突触上面的电压敏感蛋白,把一个内含神经递质的小泡(突触小体)推到突触的膜上,从而释放出突触小体中的神经递质。这些化学物质会扩散到其它神经元的树突或轴突上。
人工神经网络(Artificial Neural Network,ANN)简称 神经网络(NN),是一种模仿生物神经网络结构和功能的计算模型。大多数情况下人工神经网络能在外界信息的基础上改变内部结构,是一种自适应系统(adaptive system),通俗地讲就是具备学习功能。
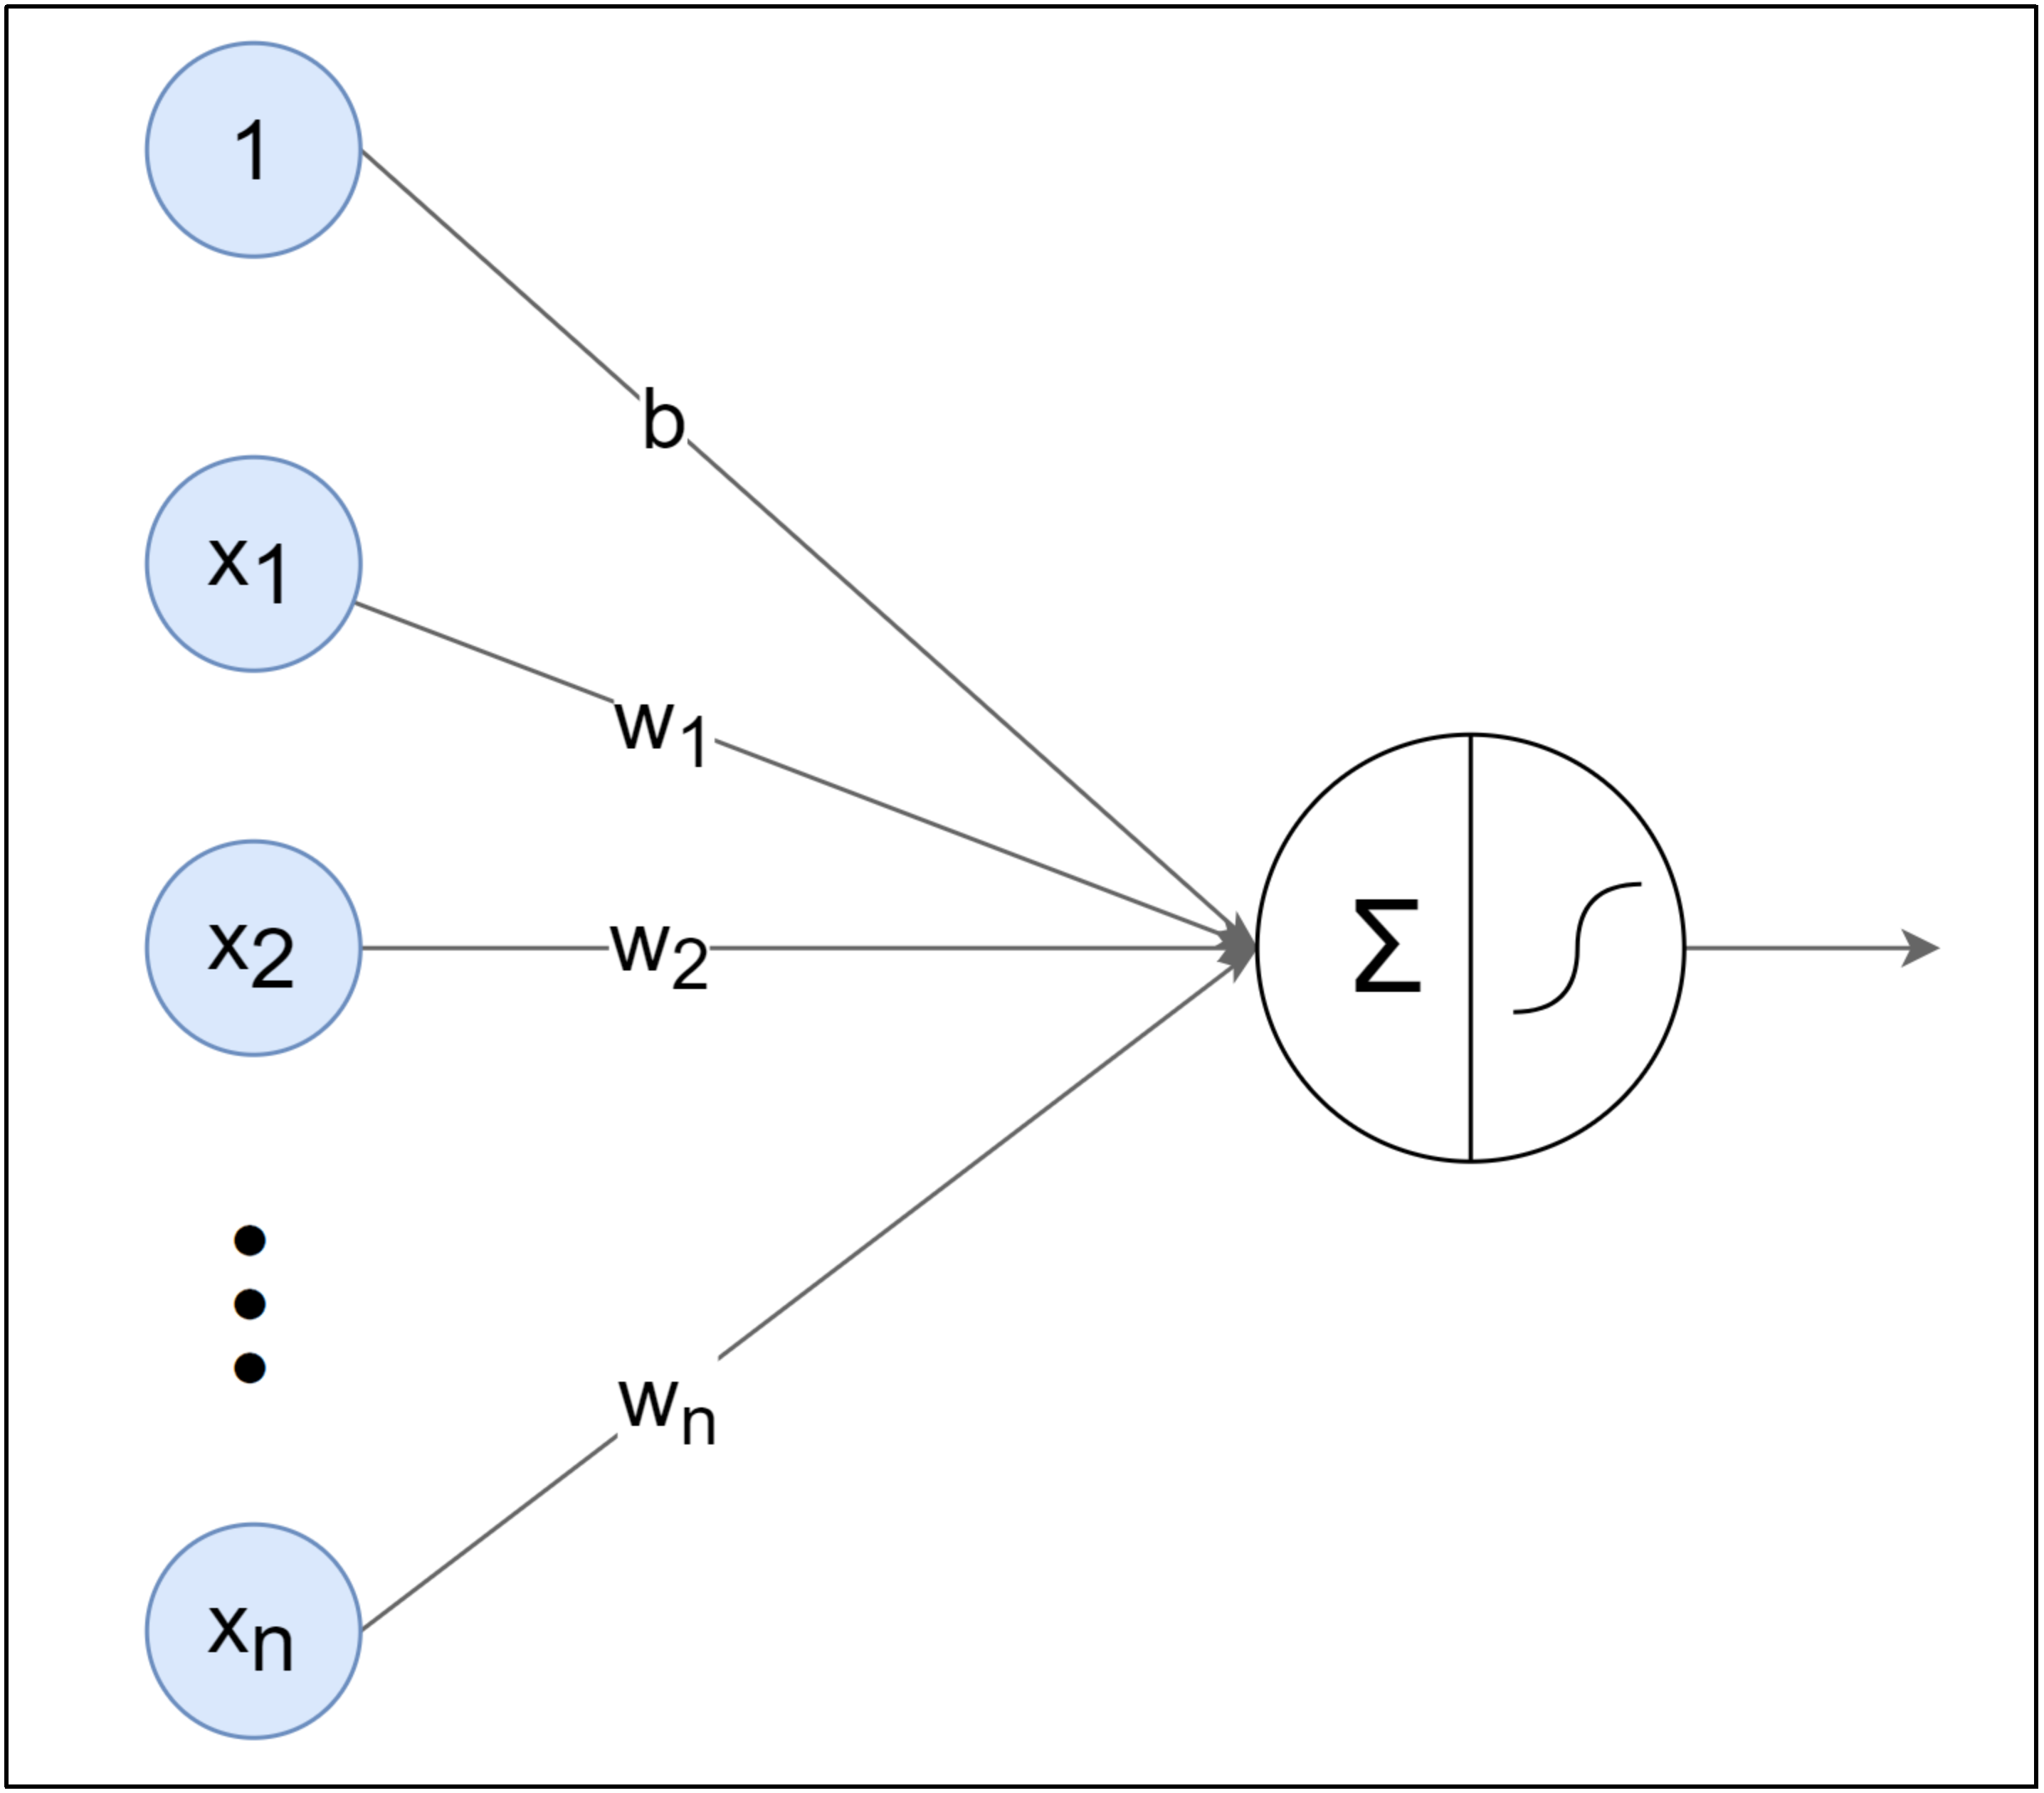
人工神经网络中的神经元,一般可以对多个输入进行加权求和,再经过特定的“激活函数”转换后输出。
- 使用多个神经元就可以构建多层神经网络,最左边的一列神经元都表示输入,称为 输入层;
- 最右边一列表示网络的输出,称为 输出层;输入层与输出层之间的层统称为 中间层(隐藏层)。
- 相邻层的神经元相互连接(图中下一层每个神经元都与上一层所有神经元连接,称为 全连接),每个连接都会有一个 权重。
- 神经元中的信息逐层传递(一般称为 前向传播forward),上一层神经元的输出作为下一层神经元的输入。
深度神经网络由多个层(layer)组成,通常将其称之为 模型(Model)。
整个模型接受原始 输入(特征),生成 输出(预测),并包含一些 参数。
而在模型内部,每个单独的层都会接受一些输入(由前一层提供),生成输出(到下一层的输入),并包含一组参数;层层向下传递,就可以得到最终的输出值。
神经网络中的参数,就是每一层的权重和偏置。
实现从输入到输出的处理计算,这个过程就是 前向传播(forward)。
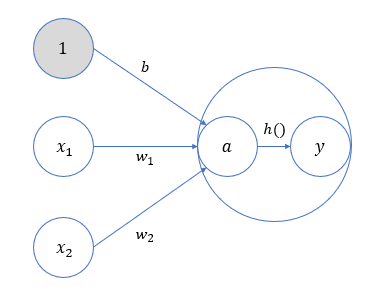
h(x) 可以将输入信号的加权总和转换为输出信号,起到“激活神经元”的作用,所以被称为 激活函数。
激活函数是连接感知机和神经网络的桥梁,在神经网络中起着至关重要的作用。 如果没有激活函数,整个神经网络就等效于单层线性变换,不论如何加深层数,总是存在与之等效的“无隐藏层的神经网络”。激活函数必须是非线性函数,也正是激活函数的存在为神经网络引入了非线性,使得神经网络能够学习和表示复杂的非线性关系。
常见的激活函数有:
- Binary Setp函数
- Sigmoid函数
- Tanh函数
- ReLU函数
- Softmax函数
- Identity函数
深度学习特点
- 使用多层神经网络,能够自动提取数据的多层次特征:深度学习模型由多个层次组成,每一层都应用非线性激活函数对输入数据进行变换。
- 自动特征提取:与传统机器学习算法不同,深度学习能够自动从原始数据中学习到有用的特征,而 不需要人工特征工程。
- 大数据和计算能力:深度学习模型通常需要大量的标准数据和强大的计算资源(如GPU)来进行训练。大数据和高性能计算使得深度学习在图像识别、自然语言处理等领域取得了显著突破
- 可解释性差:深度学习模型内部的运行机制相对不透明,被称为“黑箱”,这意味着理解模型为什么做出特定决策会比较困难。
神经网络
人工神经网络(Artificial Neural Network,简写为ANN),也简称为神经网络(NN),是一种模仿生物神经网络结构和功能的计算模型。
人脑可以看做是一个生物神经网络,由众多的神经元连接而成。各个神经元传递复杂的电信号, 树突接收到输入信号,然后对信号进行处理,通过轴突输出信号。
神经元和神经网络的内部结构
-
神经元和神经网络内部结构 - 是什么:模拟人脑的脑细胞。 - 有什么用:它是构成 AI 的最小单位。
- 树突(输入):接收外界信息(比如图片的像素点、气温数值)。
- 细胞核(计算):处理接收到的信息。
- 轴突(输出):把处理结果传出去(比如判断这是猫、预测明天25度)。
- 通俗理解:单个神经元太弱,所以把它们连起来形成“神经网络”。就像把很多个开关串联/并联起来,组成一个复杂的电路来控制机器人。
-
激活函数
-
作用:注入非线性因素,没有激活函数的网络本质仍是线性模型 如果没有激活函数,无论神经网络有多少层,最终的输出都只是输入的线性组合,表达能力非常有限(只能画直线)。激活函数引入了非线性,让神经网络能够拟合弯曲的边界,从而解决图像、语音、文本等复杂问题。
-
是什么:神经元计算完后的一个“开关按钮”。
- 为什么要用:如果不加激活函数,无论网络多深,计算结果都是线性的(一条直线),无法处理复杂图像。激活函数能让直线变弯折,赋予网络处理非线性问题的能力。
- 作用:决定这个神经元到底要不要“兴奋”并传递信号。
- 常见类型:隐藏层:ReLU(修正线性单元)、输出层有Sigmoid(二分类输出概率分布),Softmax(多分类输出概率分布)。你可以把它们理解为不同形状的“滤镜”,把计算结果限制在不同的范围内。
常见的激活函数: Sigmoid:输出0~1,适合二分类输出层,但容易导致梯度消失。 ReLU:输入≤0输出0,输入>0输出自身。计算快,缓解梯度消失,是目前最常用的隐藏层激活函数。 比喻:一个阀门:ReLU 是“小于0就关死,大于0就全开”;Sigmoid 是“把任何水流压到0~1之间”。
应用场景:所有神经网络的隐藏层(ReLU)和输出层(Sigmoid/Softmax)。
神经元的过程: 数据先经过线性求和,求和结果作为输入给到激活函数,再计算得到激活值。
- 参数初始化 - 是什么:模型开始学习前,给内部的参数(权重 W)赋的初始值。 - 有什么用:就像给天平调零。如果初始值给得太大或太小,模型可能会“学歪了”,或者直接崩溃(梯度消失/爆炸)。好的初始值能让模型更快、更稳地找到答案。
- 人工神经网络(ANN)是模仿生物神经元结构的计算模型:神经元 = 加权和(z = W·x + b)+ 激活函数(a = f(z))
- 网络三层结构:输入层 → 隐藏层(决定网络“深度”)→ 输出层;全连接网络中第 N 层每个神经元与第 N-1 层所有神经元相连
我们使用多个神经元来构建神经网络,相邻层之间的神经元相互连接,并给每一个连接分配一个强度。
- 输入层(神经元个数 = 输入特征个数)
- 中间都为隐藏层
- 输出层(神经元个数= 输出特征个数)
- 同一层的神经元之间没有连接
- 每个连接都有一个权重值(w系数和b系数)
模型训练相关概念
- Epoch 1个Epoch表示模型完整遍历一次整个训练数据集的过程。例如,训练10个Epoch表示模型将整个数据集反复学习10次。 模型需要多次遍历数据集(多个Epoch)才能逐步学习数据中的模式,单次遍历数据集(1个Epoch)通常不足以让模型收敛,多次遍历可以逐步优化模型参数。
- Batch Size Batch Size是每次训练时输入的样本数量。例如,Batch Size=32 表示每次用32个样本计算一次梯度并更新模型参数。 小批量数据计算梯度比单样本(Batch Size=1)更稳定,比全批量(Batch Size=全体数据)更高效。并且较小的Batch Size可能带来更多噪声,有助于模型泛化。
- Iteration 一次Iteration表示完成一个Batch数据的正向传播(预测)和反向传播(更新参数)的过程。
常见的深度学习模型
- 卷积神经网络(Convolutional Neural Networks, CNN)
- 循环神经网络(Recurrent Neural Networks, RNN)
- 自编码器(Autoencoders)
- 生成对抗网络(Generative Adversarial Networks, GAN)
- Transformer
- 深度强化学习(Depp Reinforcement Learning, DRL)
- 图神经网络(Graph Neural Network, GNN)
张量Tensor
张量(Tensor) 本质上就是一个多维数组,是神经网络中存储和操作数据的基本单位。
你可以把它理解为一种通用的数据容器,能够表示从零维到任意高维的数据,所有的图片、文字、声音,进入AI模型前,都要变成张量这种格式:
- 0 维 标量 单个数值(如学习率 0.001)
- 1 维 向量 一个样本的特征(如 [0.2, 0.8, 0.1])
- 2 维 矩阵 一批样本的特征表(形状 [batch_size, feature_dim])
- 3 维 三维张量 单张彩色图片([height, width, channels])
- 4 维 四维张量 一批彩色图片([batch, height, width, channels])
- 更高维 … 视频序列、Transformer 的多头注意力等
张量常用操作:
- 张量运算:像 Excel 表格一样加减乘除,告诉 GPU 怎么算。
- 索引操作:“找特定数据”。比如在一万张图片里,只取出编号为 1, 3, 5 的图片做测试。
- 形状修改 (Reshape):“乾坤大挪移”。把一张 28x28 像素的黑白图,从二维表格拉成一维的长条,以便喂给下一层神经元。
- 拼接操作:把两个数据集“缝”在一起。
为什么深度学习框架要叫它“张量”?
因为神经网络的计算天然适合用多维数组来表达: - 输入图片 → 三维张量 [H, W, C] - 卷积核 → 四维张量 [out_channels, in_channels, kernel_h, kernel_w] - 批量处理 → 再加 batch 维度变成四维/五维
深度学习框架(PyTorch、TensorFlow、JAX)都提供了 Tensor 对象,它除了存数据,还附带两个关键能力: - GPU 加速:张量可以轻松搬到 GPU 上,并行计算比 CPU 快几十倍。 - 自动求导:框架会记录对张量的所有操作,自动计算出梯度,支撑反向传播训练。
PyTorch框架
PyTorch是一个基于Python语言的深度学习框架,它将数据封装成张量(Tensor)来进行处理。
PyTorch主要有两大特征: 类似于NumPy的张量计算,能在GPU或MPS等硬件加速器上加速。 基于带自动微分系统的深度神经网络。
PyTorch中的张量就是元素为同一种数据类型的多维矩阵。 在PyTorch中,张量以类的形式分装起来,对张量的一些运算、处理的方法都被封装在类中。
PyTorch张量与NumPy数组类似,但PyTorch的张量具有GPU加速的能力(通过CUDA),这使得深度学习模型能够高效的在GPU上运行。
PyTorch提供了对张量的强大支持,可以进行高效的数值计算、矩阵操作、自动求导等。
PyTorch 在 AI Agent 开发中的核心作用是 “高性能数值计算的引擎”,主要负责两件事: - 张量运算:把文本、图像等数据转换成多维数组(Tensor),在 CPU/GPU 上高效执行矩阵乘法、激活函数等数学操作。 - 自动求导(Autograd):自动计算梯度,使得模型能够通过反向传播进行学习(微调时用到)。 对于你这样的 AI Agent 应用开发者,PyTorch 的地位类似于 Android 中的 NDK / OpenGL ES: 你不需要手写底层数学库或训练算法,就像做安卓 App 不需要自己写 SurfaceFlinger。 你通过上层框架(如 Hugging Face Transformers、LangChain)间接使用 PyTorch,用来加载预训练模型、做推理、做 LoRA 微调。 你主要接触的是 torch.tensor、torch.no_grad()、model.to(device) 这几个 API,其余大部分被封装在 Transformers 库中。 一句话总结:PyTorch 是 AI Agent 背后所有模型运行的“发动机”,作为应用开发者,只需要知道怎么点火(加载模型)、挂挡(推理/微调)、踩油门(GPU加速)。
根据指定数据创建张量:
t1 = torch.tensor([1.9, 2.0, 2.0])
print(t1)
类型转换 默认是float32
t1 = torch.tensor(data=888)
print(t1.dtype)
t2 = t1.type(dtype=torch.float32)
print(t2.dtype)
numpy与Tensor互转
import torch
import numpy as np


t1 = torch.tensor([11, 22, 33])
print(t1)

# 默认共享内存
arr1 = t1.numpy()
# 调用copy后,默认不共享内存,就是一个深拷贝
# arr1 = t1.numpy().copy()
print(type(arr1))
print(arr1)

t1[1] = 999
print(f"张量{t1}")
print(f"Numpy: {arr1}")

arr2 = np.array([11, 22, 33])
print(type(arr2))
print(arr2)
# numpy 转张量,会共享内存
t2 = torch.from_numpy(arr2)

# tourch.tensor(numpy) 不会共享内存
print(t2)
自动微分模块
训练神经网络时,最常用的算法就是反向传播(BP算法)。
在该算法中,参数(模型权重)会根据损失函数关于对应参数的梯度进行调整。
也就是说在进行反向传播的过程中,需要不断的求梯度值。 而梯度值就是到数值,为了得到到数值,通过自动微分计算。
为了计算这些梯度,PyTorch内置了torch.autograd的微分模块,支持任意计算图的自动梯度计算。
前向传播(Forward Propagation)
- 是什么:“顺着算一遍”。数据从输入端流向输出端的过程。
- 作用:得出预测结果。
- 场景:给模型一张猫的图片,数据一层层经过计算,最后输出“这是猫,概率是98%”。这就是一次前向传播。
反向传播(Back Propagation)
- 是什么:“倒着找错误”。
- 核心作用:这是深度学习的核心魔法。前向传播算出了结果,但结果是错的怎么办?
- 反向传播会从结果倒推回去,计算每个参数(权重)对错误的“贡献度”(这也就是梯度)。
- 通俗比喻:你投篮没进(预测错误)。你的大脑会瞬间分析:是手肘角度不对?还是发力时机不对?下次投篮就把角度微调一下。反向传播就是在干这件事。
反向传播(Backward Propagation或Back Propagation,BP算法)指的是计算神经网络参数梯度的方法。简言之,该方法根据微积分中的链式法则,按相反的顺序从输出层到输入层遍历网络。该算法存储了计算某些参数梯度时所需的任何中间变量。
全连接层(nn.Linear)
在神经网络中,参数主要位于全连接层(仿射层Affine)中。
PyTorch提供了torch.nn模块,专门用于神经网络的构建和训练。其中全连接层被实现为Linear类,内部有两个属性:权重 weight和偏置bias;这就是神经网络的主要参数。
自定义模型
在神经网络框架中,由多个层组成的组件称之为 模块(Module)。 在PyTorch中模型就是一个Module,各网络层、模块也是Module。Module是所有神经网络的基类。 在定义一个Module时,我们需要继承torch.nn.Module并主要实现两个方法: init:定义网络各层的结构,并初始化参数。 forward:根据输入进行前向传播,并返回输出。计算其输出关于输入的梯度,可通过其反向传播函数进行访问(通常自动发生)。forward方法是每次调用的具体实现。
损失函数 (Loss Function)
- 是什么:“评分标准”。衡量模型预测得有多离谱。
- 作用:给出一个具体的分数。分数越高,说明模型越笨;我们要通过训练把这个分数降到最低。
- 常用分类:
- 回归(多分类):比如预测房价,误差可以很大,用 MSE(均方误差)。
- 二分类:比如判断垃圾邮件,非黑即白,用 BCE(二元交叉熵)。
- 回归(数值):预测具体数值,比如股票、气温。
在多分类任务通常使用softmax将logits转换为概率的形式,所以多分类的交叉熵损失也叫做softmax损失。
混合精度训练
混合精度训练是指在深度学习模型训练时,一些操作使用 torch.float32(单精度)数据类型以保证数值稳定性,而其他操作使用 torch.float16(半精度)以减少显存占用和加快计算速度,从而在不影响模型精度和收敛效果的前提下,实现更高效的训练。 在 PyTorch 中,混合精度训练通常使用 自动混合精度(Automatic Mixed Precision, AMP)模块实现,主要依赖以下两个组件: - torch.autocast: torch.autocast 是 PyTorch 自动混合精度(AMP)的上下文管理器,用于自动选择适当的精度进行计算。例如,在卷积、矩阵乘法等可使用半精度加速的操作中使用 torch.float16,而在归一化、损失计算等需要高精度的操作中保持 torch.float32,从而在节省显存和加速训练的同时保证数值稳定性。 - torch.cuda.amp.GradScaler: torch.cuda.amp.GradScaler 是用于动态损失缩放(Dynamic Loss Scaling)的工具,用来防止在使用半精度训练时因梯度值过小导致的下溢(underflow),保证训练过程稳定收敛。它会动态调整缩放因子,将损失放大后再进行反向传播以避免梯度消失,在优化器更新时再自动缩小回原始范围,同时监控是否出现溢出并动态调整缩放值。 配合正常的训练循环,即可稳定、高效地完成混合精度训练。
CUDA
CUDA(Compute Unified Device Architecture)是NVIDIA开发的并行计算平台和编程平台,允许开发者利用NVIDIA GPU的强大计算能力进行通用计算。CUDA不仅用于图形渲染,还广泛应用于科学计算、深度学习、金融建模等领域。