1.C语言简介(一)
低级语言vs高级语言
在计算机世界中,把用二进制代码表示的计算机能直接识别和执行的指令和数据的集合(程序)称为“机器语言”(面向机器的语言)。
机器语言是唯一一种CPU能直接理解并执行的编程语言,用其他语言编写的程序计算机是不能直接运行的,必须先转换成机器语言。
机器语言是最底层的计算机语言,用机器语言编写的程序都是由8bit(1Byte)二进制数构成的。每个8bit的二进制数都是有特定含义的指令或数据。可对于人而言,看到的都是0和1的组合,很难判断各个组合都表示什么。
于是就有人发明了另一种编程方法,根据表示指令功能的英语单词给每一种指令起一个相似的昵称,并用这个昵称来代替表示指令的0和1 的二进制数组合,而数据则用我们更容易接受的十六进制数或十进制数来表示。这种类似英语单词的昵称叫作“助记符”,我们把这种使用“助记符”的编程语言称为“汇编语言”。
用汇编语言编写的程序计算机是不能直接运行的,必须先转换成机器语言。机器语言是唯一一种CPU能直接理解并执行的编程语言。
汇编语言的助记符以及数据和机器语言的二进制代码都是一一对应的,都是针对计算机硬件的,也就是说都是面向机器的语言。不同的计算机硬件(CPU)所用的助记符和二进制代码是不一样的,所以这样的程序其通用性不好,如果把它移植到其他的计算机上就无法正常运行了。我们通常把机器语言和汇编语言称为低级语言。
低级语言分机器语言(二进制语言)和汇编语言(符号语言),这两种语言都是面向机器的语言,和具体机器的指令系统密切相关。
采用了助记符的汇编语言虽然比机器语言直观且容易理解和记忆,但是由于汇编语言依赖于硬件体系,且助记符量大难记,学习和理解这样的程序依然非常困难,于是人们又发明了更加易用的所谓高级语言。
高级语言是以人类日常语言为基础的一种编程语言,使用一般人易于接受的文字和数学公式来表示(通常是英语),其语法和结构更类似于普通英文。由于高级语言远离对硬件的直接操作,每个人经过学习后都可以编程,且程序具有较高的可读性,以方便对电脑认知比较浅的人也可以大概明白其内容。
我们通常将使用高级语言编写的程序通常称为源代码(Source code)。
高级语言并不是特指的某一种具体的语言,而是包括很多编程语言,如流行的 C、C++、C#、Pascal、BASIC、Visual Basic、Java、Python、Lisp、PHP 等等,这些语言的语法、命令格式都各不相同。
用高级语言编写的程序源代码不能直接被CPU识别和执行,必须转换成对应的目标代码(机器语言)才能被识别和执行。对CPU来说母语是机器语言,而转换成机器语言的程序就是本地代码。这种转换过程被称为编译(Compile)。
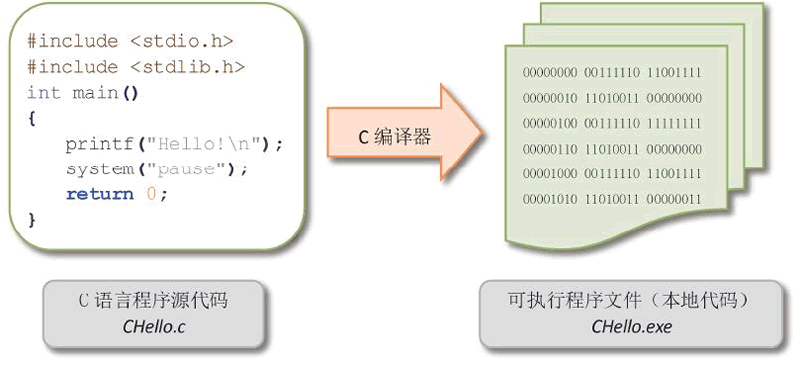
不同高级语言的语法及命令格式都不相同,所以将其转换为目标代码(机器语言)的方式也不一样,每种高级语言都有对应的编译器。比如,常用的C语言编译器(C compiler)有 Turb C、gcc、C-Free、Borland C++、Microsoft Visual C++ 等。
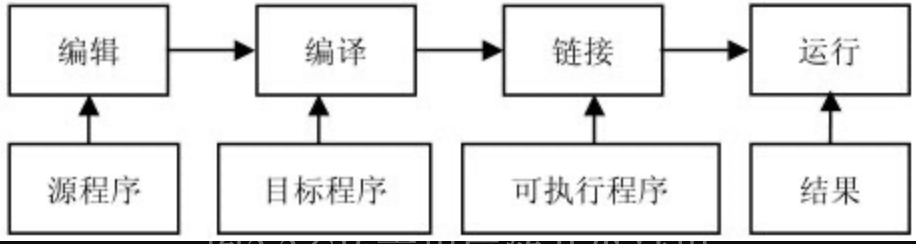
把高级语言翻译成机器语言的过程称为“编译”。对C程序来说,先要通过“编译程序”将源程序翻译成二进制形式的“目标程序”,然后再通过“链接程序”将该目标程序与系统的库函数及其他目标程序链接起来,形成可执行目标程序。
C语言
C语言是一种通用的高级语言,最初是由丹尼斯·里奇在贝尔实验室为开发UNIX操作系统而设计的。C语言最开始是于1972年在DEC PDP-11计算机上被首次实现。
在1978年,布莱恩·柯林汉(Brian Kernighan)和丹尼斯·里奇(Dennis Ritchie)制作了C的第一个公开可用的描述,现在被称为K&R标准。
UNIX操作系统,C编译器,和几乎所有的UNIX应用程序都是用C语言编写的。由于各种原因,C 语言现在已经成为一种广泛使用的专业语言。
- 易于学习。
- 结构化语言。
- 它产生高效率的程序。
- 它可以处理底层的活动。
- 它可以在多种计算机平台上编译。
关于C
- C语言是为了编写UNIX操作系统而被发明的。
- C语言是以B语言为基础的,B语言大概是在1970年被引进的。
- C语言标准是于1988年由美国国家标准协会(ANSI,全称American National Standard Institute)制定的。
- 截至1973年,UNIX操作系统完全使用C语言编写。
- 目前,C语言是最广泛使用的系统程序设计语言。
- 大多数先进的软件都是使用C语言实现的。
- 当今最流行的Linux操作系统和RDBMS(Relational Database Management System:关系数据库管理系统)MySQL都是使用C语言编写的。
Hello World
#include <stdio.h>

int main() {
    printf("Hello World! \n");
    return 0;
}
保存文件为HelloWorld.c。
接下来,就需要把程序转化为机器可以执行的形式。对于C程序来说,通常包含下列3个步骤:
-
预处理
首先程序会被送交给预处理器(preprocessor)。预处理器执行以#开头的命令(通常称为指令)。预处理器有点类似于编辑器,它可以给程序添加内容,也可以对程序进行修改。
-
编译
修改后的程序现在可以进入编译器(compiler)了。编译器会把程序翻译成机器指令(即目标代码)。然而,这样的程序还是不可以运行的。
-
链接
在最后一个步骤中,链接器(linker)把由编译器产生的目标代码和所需的其他附加代码整合在一起,这样才最终产生了完全可执行的程序。这些附加代码包括程序中用到的库函数(如printf函数)。
然后打开命令行进入到当前目录并且通过如下命令进行编译:
gcc HelloWorld.c
GNU C compiler简称GCC编译器是最流行的C编译器之一。
编译完成后会生成a.out的可执行文件。
然后执行a.out
./a.out
就会在屏幕上显示Hello World!
C语言和Java一样,分号是语句结束符。也就是说,每个语句都必须以分号结束。它表明一个逻辑实体的结束。
注释
在C中注释和Java中也一样,都是//和/* */
变量
C中变量的定义和Java一样,都是type name
例如:
int i, j, k;
char c, ch;
float f;
doubule d;
int d = 3, f = 5;
char x = 'x';
static int y = 10; // 静态变量
extern int x = 10; // 外部变量也叫全局变量,可以通过使用外部变量来共享多个c源文件中的变量。
变量声明向编译器保证变量以指定的类型和名称存在,这样编译器在不需要知道变量完整细节的情况下也能继续进一步的编译。
变量声明只在编译时有它的意义,在程序连接时编译器需要实际的变量声明。
变量的声明有两种情况:
- 一种是需要建立存储空间的。例如:int a 在声明的时候就已经建立了存储空间。
- 另一种是不需要建立存储空间的,通过使用extern关键字声明变量名而不定义它。 例如:extern int a其中变量a可以在别的文件中定义的。
- 除非有extern关键字,否则都是变量的定义。
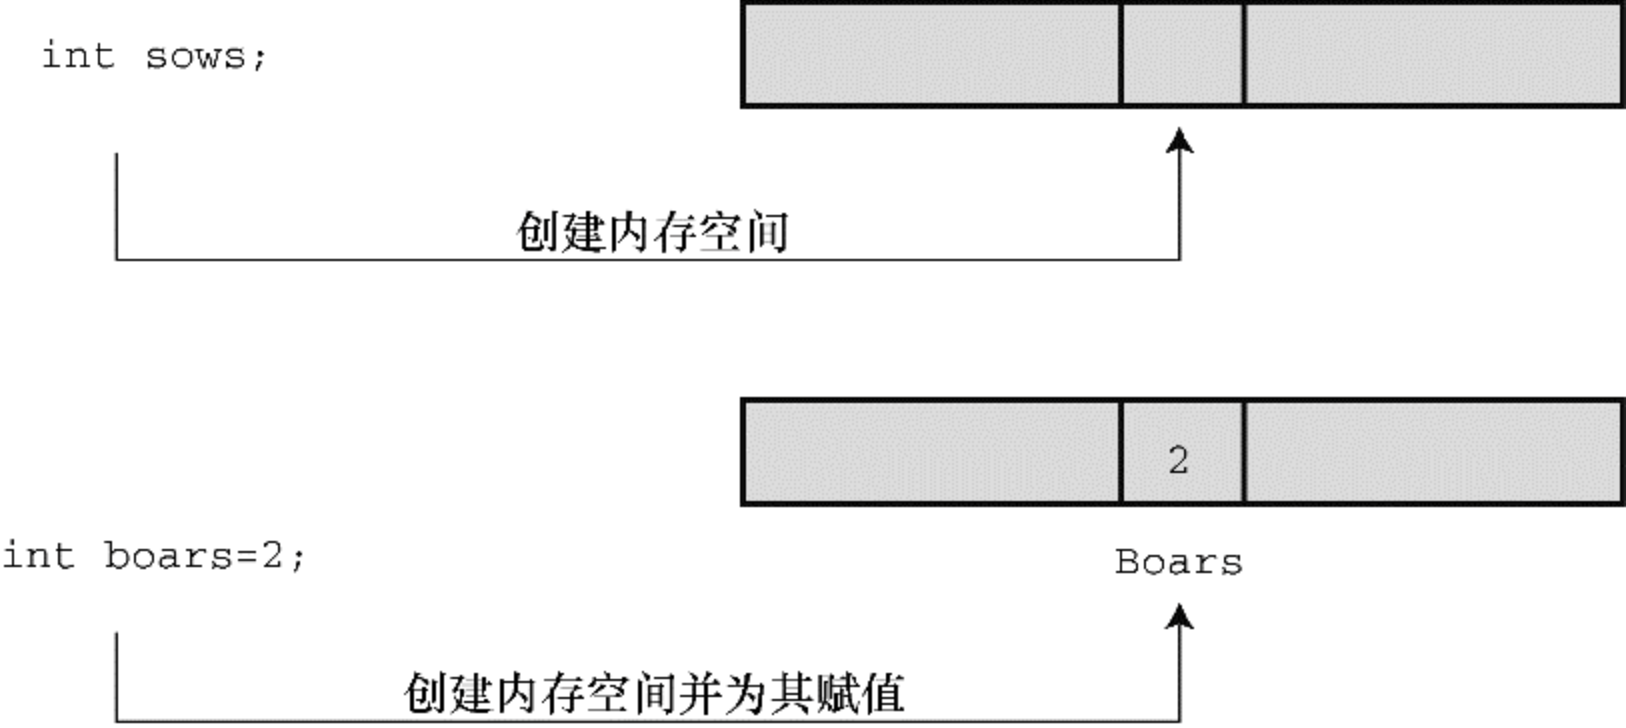
extern int i; //声明,不是定义
int i; //声明,也是定义
例如下面的例子中,变量在头部就已经被声明,但是定义与初始化在主函数内:
#include <stdio.h>

// 变量声明
extern int a, b;
extern int c;
extern float f;

int main () {
    /* 变量定义 */
    int a, b;
    int c;
    float f;

    /* 初始化 */
    a = 10;
    b = 20;

    c = a + b;
    printf("value of c : %d \n", c);

    f = 70.0/3.0;
    printf("value of f : %f \n", f);

    return 0;
}
然后局部变量、成员变量神马的和Java都是一样一样滴
变量的存储分类
存储分类用于定义变量的范围和使用寿命。C语言编程中有四个存储分类。它们分别如下:
- auto
- extern
- static
- register
| 存储类 | 存储地点 | 默认值 | 范围 | 生命周期 |
|---|---|---|---|---|
| auto | RAM | 垃圾值 | 局部 | 函数中 |
| extern | RAM | 零 | 全局 | 直到主程序结束,可以在程序的任何地方声明 |
| static | RAM | 零 | 局部 | 直到主程序结束,保留多个函数之间的值调用 |
| register | 寄存器 | 垃圾值 | 局部 | 函数中 |
1. auto变量
auto关键字自动应用于所有局部变量。它是默认存储类,这就是为什么它被称为自动变量。
#include <stdio.h>
void main() {
    int a = 10;
    auto int b = 10;//same like above
    printf("%d %d", a, b);
}
执行上面示例代码,得到以下结果:
10 10
2.register变量
register声明告诉编译器,它所声明的变量在程序中使用频率较高。
其思想是,将register变量放在机器的寄存器中,这样可以使程序更小、执行速度更快。
但编译器可以忽略此选项。其大小与寄存器大小相同。它比其他变量的访问速度更快。
建议仅使用寄存器变量进行快速访问,如计数器。
注意:我们无法获取寄存器变量的地址。
声明示例:
register int counter = 0;
3.static变量
静态变量只初始化一次,直到程序结束。它在多个函数调用之间保留其值。
静态变量的默认值为0,由编译器提供。
#include <stdio.h>
void func() {
    static int i = 0;//static variable
    int j = 0;//local variable
    i++;
    j++;
    printf("i= %d and j= %d\n", i, j);
}

void main() {
    func();
    func();
    func();
}
执行上面示例代码,得到以下结果 -
i= 1 and j= 1
i= 2 and j= 1
i= 3 and j= 1
4.extern变量
所有程序都可以看到(或访问)extern变量。如果两个或多个文件共享相同的变量或函数,则可使用extern变量。
extern int counter = 0;
常量
常量可以是任何的基本数据类型,比如整数、字符、字符串及枚举等。
整数常量可以是十进制、八进制或十六进制的常量。
前缀指定基数:0x或0X表示十六进制,0表示八进制,不带前缀则默认表示十进制。
整数常量也可以带一个后缀,后缀是U和L的组合,U表示无符号整数(unsigned),L 表示长整数(long)。后缀可以是大写,也可以是小写U和L的顺序任意。
在C中有两种简单的定义常量的方式:
- 使用#define预处理器
- 使用const关键字
#include <stdio.h>

#define LENGTH 10
#define WIDTH  5
static int area;
int main() {
    area = LENGTH * WIDTH;
    printf("value of area : %d", area);

    const char NEWLINE = '\n';
    printf("%c", NEWLINE);
    return 0;
}
执行结果:
value of area : 50
C const和C++ const
C和C++中const的用法很类似,但是并不完全相同。
- 区别之一是,C++允许在声明数组大小时使用const整数,而C却不允许。
- 区别之二是,C++的指针赋值检查更严格:
const int y;
const int* p2 = &y;
int* p1;
p1 = p2; // C++中不允许这样做,但是C可能只给出警告
C++不允许把const指针赋给非const指针。而C则允许这样做,但是如果通过p1更改y,其行为是未定义的。
整体来说就是const可以创建在程序运行过程中不能改变的变量,可具有文件作用域或块作用域。另一方面,宏常量可用于指定标准数组的大小和const变量的初始值:
#define LIMIT 20
const int LIM = 50;
static int data1[LIMIT];   // 有效
static int data2[LIM];     // 无效
const int LIM2 = 2 * LIMIT; // 有效
const int LIM3 = 2 * LIM;   // 无效
这里解释一下上面代码中“无效”注释。在C中,非自动数组的大小应该是整型常量表达式,这意味着表示数组大小的必须是整型常量组合、枚举常量和sizeof表达式,不包括const声明的值(这也是C++和C的区别之一,在C++中可以把const值作为常量表达式的一部分).
运算符
算数运算符、逻辑运算符等和Java基本都一样。
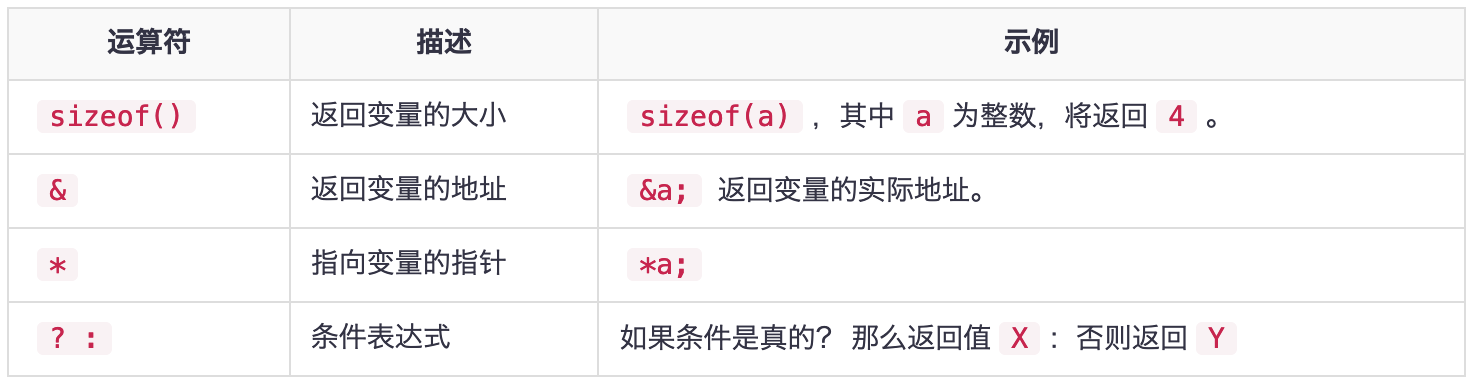
- sizeof():返回变量的大小,例如sizeof(a)将返回4,其中a是整数。这里要注意sizeof并不是一个函数,而是一个运算符
- &:返回变量的地址,例如&a将给出变量的实际地址,和Go语言中的一样
- *:指向一个变量,和Go语言的一样。
?::三元运算符,和Java一样 b = (a == 1)? 20 : 30
其他的判断语句例如:
if () {

} else {

}

switch(a) {
    case 1:
    ...
    break;
    case 2:
    ...
    break;

    default:
    ....
}

while() {

}

for ( ; ; ) {

}

do {

} while() {

}

break

goto
和Java的都一样。
头文件
头文件是扩展名为.h的文件,包含了C函数声明和宏定义,被多个源文件中引用共享。
有两种类型的头文件:
- 程序员编写的头文件
- 编译器自带的头文件。
预处理指令以符号“#”开头,C语言常用的预处理指令包括:
#include         //包含文件
#define          //定义常量
在程序中要使用头文件,需要使用C预处理指令#include来引用它。前面我们已经看过stdio.h头文件,它是编译器自带的头文件。
引用头文件相当于复制头文件的内容,但是我们不会直接在源文件中复制头文件的内容,因为这么做很容易出错,特别在程序是由多个源文件组成的时候。
使用预处理指令#include可以引用用户和系统头文件。它的形式有以下两种:
-
#include <file>
这种形式用于引用系统头文件。它在系统目录的标准列表中搜索名为file的文件。在编译源代码时,您可以通过-I选项把目录前置在该列表前。 -
#include "file"
这种形式用于引用用户头文件。它在包含当前文件的目录中搜索名为file的文件。在编译源代码时,您可以通过-I选项把目录前置在该列表前。
define预处理指令用来定义常量。用 #define定义的常量使用(调用)方法和变量一样,但它们不是变量,不能像变量一样被赋值,在程序运行中它们的值始终保持不变。#define指令的格式如下:
#define <符号常量名> <常量值>       //符号常量名一般大写
例如:
#define PI 3.14159               //定义常量 PI 的值为 3.14159
#define MYNAME "王小石"           //定义常量 MYNAME 的值为“王小石”
只引用一次头文件
如果一个头文件被引用两次,编译器会处理两次头文件的内容,这将产生错误。为了防止这种情况,标准的做法是把文件的整个内容放在条件编译语句中,如下:
#ifndef HEADER_FILE
#define HEADER_FILE

the entire header file file

#endif
这种结构就是通常所说的包装器#ifndef。当再次引用头文件时,条件为假,因为HEADER_FILE已定义。此时,预处理器会跳过文件的整个内容,编译器会忽略它。
有条件引用
有时需要从多个不同的头文件中选择一个引用到程序中。例如,需要指定在不同的操作系统上使用的配置参数。您可以通过一系列条件来实现这点,如下:
#if SYSTEM_1
   # include "system_1.h"
#elif SYSTEM_2
   # include "system_2.h"
#elif SYSTEM_3
   ...
#endif
但是如果头文件比较多的时候,这么做是很不妥当的,预处理器使用宏来定义头文件的名称。这就是所谓的有条件引用。它不是用头文件的名称作为#include的直接参数,您只需要使用宏名称代替即可:
 #define SYSTEM_H "system_1.h"
 ...
 #include SYSTEM_H
SYSTEM_H会扩展,预处理器会查找system_1.h,就像#include最初编写的那样。SYSTEM_H可通过-D选项被您的Makefile定义。
强制类型转换
强制类型转换是把变量从一种类型转换为另一种数据类型。
例如,如果您想存储一个long类型的值到一个简单的整型中,您需要把long类型强制转换为int类型。
您可以使用强制类型转换运算符来把值显式地从一种类型转换为另一种类型,如下所示:
#include <stdio.h>

int main() {
    int sum = 17, count = 5;
    double mean;

    mean = (double) sum / count;
    printf("Value of mean : %f\n", mean );
}
函数
函数是一组一起执行一个任务的语句。
每个C程序都至少有一个函数,即主函数main() ,所有简单的程序都可以定义其他额外的函数。
函数声明告诉编译器函数的名称、返回类型和参数。函数定义提供了函数的实际主体。
C标准库提供了大量的程序可以调用的内置函数。例如,函数strcat()用来连接两个字符串,函数memcpy()用来复制内存到另一个位置。
函数还有很多叫法,比如方法、子例程或程序,等等。
函数的定义和Java也都一样,例如上面我们在HelloWorld里面写的main函数。
void pound(int n) {
    while(n-- > 0) {
        printf("#");
    }
}
可变参数
#include <stdio.h>
#include <stdarg.h>
 // 使用可变参数,需要先引用stdarg.h头文件
 double average(int num,...) {
    va_list valist;
    double sum = 0.0;
    int i;

    /* 为 num 个参数初始化 valist */
    va_start(valist, num);

    /* 访问所有赋给 valist 的参数 */
    for (i = 0; i < num; i++) {
        sum += va_arg(valist, int);
    }
    /* 清理为 valist 保留的内存 */
    va_end(valist);
    return sum/num;
}

int main() {
   printf("Average of 2, 3, 4, 5 = %f\n", average(4, 2,3,4,5));
   printf("Average of 5, 10, 15 = %f\n", average(3, 5,10,15));
}
数组
数组和Java也是一样一样滴
double balance[5] = {1000.0, 2.0, 3.4, 7.0, 50.0};
balance[4] = 50.0;
运算符sizeof可以确定数组的大小(字节数)。
如果数组a有10个整数,那么sizeof(a)通常为40.而每个数组元素的大小为sizeof(a[0]),所以用数组的大小除以数组元素的大小就可以得到数组的长度。
int size = (int)(sizeof(a) / sizeof(a[0]) // 数组大小
for (i = 0; i < size; i++) {

}
数组的传递不可能通过拷贝的方式来传递。
C语言基于效率的原因,在传递的时候,数组名仅充当数组中的首元素地址使用。
数组有三个要素: - 起始地址 - 步长(刻度) - 数组长度
数组名是一个指针包含了(起始地址、步长),但数组名里面没有包含整个数组的长度,所以在传递一维数组的时候,要传数组名和数组的长度。
typedef关键字
C语言提供了typedef关键字,可以使用它来为类型取一个别名:
typedef unsigned char BYTE;
在这个类型定义之后,标识符BYTE可作为类型unsigned char的缩写,例如:
BYTE b1, b2;
按照惯例,定义时会用大写字母,以便提醒该类型名称是一个象征性的缩写。 当然你也可以小写。
#include <stdio.h>
#include <string.h>

typedef struct Books {
    char title[50];
    char author[50];
    int  book_id;
} Book;

int main() {
    Book book;

    strcpy( book.title, "C 教程");
    strcpy( book.author, "Runoob");
    book.book_id = 12345;
    return 0;
}
typedef vs #define
define是C指令,用于为各种数据类型定义别名,与typedef类似,但是它们有以下几点不同:
- typedef仅限于为类型定义符号名称,#define不仅可以为类型定义别名,也能为数值定义别名,比如您可以定义1为ONE。
- typedef是由编译器执行解释的,#define语句是由预编译器进行处理的。
#include <stdio.h>

#define TRUE  1
#define FALSE 0

int main( ) {
    printf( "TRUE 的值: %d\n", TRUE);
    printf( "FALSE 的值: %d\n", FALSE);
    return 0;
}
枚举
枚举和Java也是一样一样滴,用enum来定义
enum DAY
{
      MON=1, TUE, WED, THU, FRI, SAT, SUN
};
enum DAY day;
// 别名
typedef enum {XXX, XXXX} Suit;
Suit s1;
字符串
一些编程语言为声明字符串变量提供了专门的string类型。
C语言采取了不同的方式:只要保证字符串是以空字符结尾的,任何一维数组都可以用来存储字符串。
在C语言中,字符串实际上是使用null字符'\0'终止的一维字符数组。
因此,一个以null结尾的字符串,包含了组成字符串的字符。
下面的声明和初始化创建了一个"Hello"字符串。由于在数组的末尾存储了空字符,所以字符数组的大小比单词"Hello"的字符数多一个。
char greeting[6] = {'H', 'e', 'l', 'l', 'o', '\0'};
字符串是以空字符(\0)结尾的char类型数组。一定要注意它是一个char类型的数组。
字符串常量是一个字符数组,例如“I am a string"。在字符串的内部表示中,字符数组以空字符'\0'结尾。
用双引号括起来的内容称为字符串字面量(string literal),也叫做字符串常量(string const)。
双引号中的字符和编译器自动加入末尾的\0字符,都作为字符串存储在内存中。
字符串常量属于静态存储类别(static storage class),这说明如果在函数中使用字符串常量,该字符串只会被存储一次,在整个程序的生命周期内存在,即使函数被调用多次。
用双引号括起来的内容被视为指向该字符串存储位置的指针,这类似于把数组名作为指向该数组位置的指针。
这里一定要注意最后的空字符,没有这个空字符,这就不是一个字符串,而是一个字符数组。
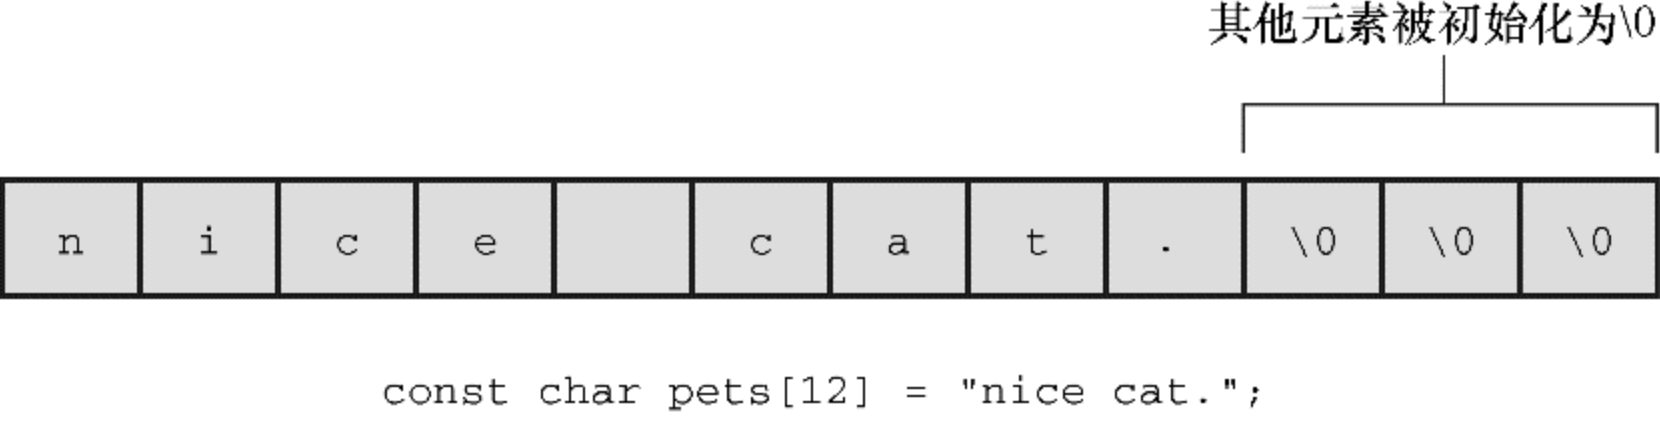
在指定数组大小时,要确保数组的元素个数至少比字符串长度多1(为了容纳空字符)。
所有未被使用的元素都被自动初始化为0(这里的0指的是char形式的空字符,而不是数字字符0),如下图:
通常,让编译器确定数组的大小很方便,可以省略数组初始化声明中的大小,编译器会自动计算数组的大小:
char greeting[] = "Hello";
假设需要用一个变量来存储最多有80个字符的字符串。由于字符串在末尾处需要有空字符,我们把变量声明为含有81个字符的数组:
#define STR_LEN 80
...
char str[STR_LEN + 1];
char date[] = "June 14";
char *date = "June 14";
前者声明date是一个数组,后者声明date是一个指针。
正因为有了数组和指针之间的紧密关系,才使上面这两个声明中的date都可以用作字符串。
在声明为数组时,date是数组名。在声明为指针时,date是变量,这个变量可以在程序执行期间指向其他字符串。
C语言中将常量字符串处理为一个存放到内存数据区的这段字符串的首地址。 char *正好能代表了整个字符串(起始地址、步长、'\0')。
所以到目前为止共有三种形式的字符串:
- 字符串常量: 存储于内存的rodata段,编译为指针,以'\0'结尾,例如"abcd"。
- 字符指针: 用于指向字符串常量,但不能更改内容,例如char *p = "abcd"。
- 字符数组: 用于存储可更改字符串的数组,例如char str[] = "abcd"。
C提供了string.h头,在
字符串形式参数声明为char *类型,这使得实际参数可以是字符数组、char *类型的变量或者字符串字面量。
例如:
char *strcpy(char *s1, const char *s2);
strcpy函数把字符串s2复制给字符串s1。准确的说,应该是strcpy函数把s2指向的字符串复制到s1指向的数组中。
这里为什么形式参数是const char *s2,而不是const char s2[] ?
从技术方面看,两者等价且有效。
使用带方括号的写法是为了提醒用户:该函数处理的是数组。
然而,如果要处理字符串,实际参数可以是数组名、用双引号括起来的字符串,或声明为char *类型的变量。
用const char *s2可以提醒用户:实际参数不一定是数组。
#include <stdio.h>
void put1(const char *);

int main(void) {
    put1("If I'd has much money");
    return 0;
}
void put1(const char * string) {
    while(*string) { // 与*string != '\0'相同
        putchar(*string++);
    }
}
C中提供了大量操作字符串的函数:
- strcpy(s1, s2);复制字符串s2到字符串s1中
- strcat(s1, s2);连接字符串s2到字符串s1的末尾
- strlen(s1);返回字符串s1的长度,不包含"\0"的截止字符,也就是说strlen知道字符串在何处停止
- strcmp(s1, s2);如果s1和s2是相同的,则返回0;如果s1
s2则返回大于0 - strchr(s1, ch);返回一个指针,指向字符串s1中字符ch的第一次出现的位置。
- strstr(s1, s2);返回一个指针,指向字符串s1中字符串s2的第一次出现的位置。
也就是说C中不像Java那样用String,它没有专门的字符串变量,C把字符串作为字符数组来处理。
puts()和printf()区别
相同点: - 两者都属于stdio.h这个头文件 - 都能输出字符串
不同点: puts()在输出字符串时会将’\0’自动转换成’\n’进行输出,也就是说,puts方法输出完字符串后会自动换行。
system()方法
C语言内置函数system()的功能是向计算机发出DOS命令:
用C语言删除文件
#include <stdlib.h>
#include <stdio.h>
int main(void){
    system("del d:\\123.txt");
    return 0;
}
++/--
自增运算符++的功能是使变量的值自增1,自减运算符--的功能是使变量的值自减 1。
++与--这两个运算符特殊的地方主要表现在:
它们既可以用作前缀运算符(用在变量前面,如++n),也可以用作后缀运算符(用在变量后面,如n++)。
在这两种情况下,其效果都是将变量n的值加1。
但是,它们之间有一点不同。表达式++n先将n的值递增1,然后再使用变量n的值,而表达式n++则是先使用变量n的值,然后再将n的值递增1。也就是说,对于使用变量n的值的上下文来说。++n和n++的效果是不同的。
C语言中的自增与自减运算实例:
#include <stdio.h>
#include <stdlib.h>
int main(){
    int i = 5;                      //i 的初始值为 5
    printf("%d\n",++i);             //加 1 后输出,输出为 6;此时 i 为 6
    printf("%d\n",--i);             //减 1 后输出,输出为 5;此时 i 为 5
    printf("%d\n",i++);             //输出后再加 1,输出为 5;此时 i 为 6
    printf("%d\n",i--);             //输出后再减 1,输出为 6;此时 i 为 5
    printf("%d\n",-i++);            //输出 -i 后再加 1,输出为 -5;此时 i 为 6
    printf("%d\n",-i--);            //输出 -i 后再减 1,输出为 -6;此时 i 为 5
    system("pause");
    return 0;
}
运算结果为:
6 5 5 6 -5 -6
- 邮箱 :charon.chui@gmail.com
- Good Luck!