1.C++基础
每个C++程序都包含一个或多个函数(function),其中一个必须命名为main()。
操作系统通过调用main()来运行C++程序。下面是一个非常常见的main()函数,它什么也不干,只返回给系统一个值:
int main() {
    return 0;
}
一个函数的定义包含四个部分: - 返回类型(return type) - 函数名(function name) - 形参列表(parameter list) - 函数体(function body)
main函数的返回类型必须是int,即整数类型。int类型是一种内置类型(built-in type),即语言自身定义的类型。
输入输出
C++语言并未定义任何输入输出(IO)语句,取而代之,包含了一个全面的标准库(standard library)来提供IO机制(以及很多其他设施)。
iostream库包含两个基础类型:istream和ostream,分别表示输入流和输出流。一个流就是一个字符序列,是从IO设备读出或写入IO设备的。
术语“流”(stream)想要表达的意思是,随着时间的推移,字符是顺序生成或消耗的。
标准库定义了4个IO对象:
- 为了处理输入,使用cin的istream类型的对象,这个对象也被成为标准输入(standard input)。
- 对于输出使用cout的ostream类型的对象,这个对象也被成为标准输出(standard output)。
- 用cerr来输出警告和错误消息,因此它也被成为标准错误(standard error)。
- 用clog用来输出程序运行时的一般性信息。
#include "iostream"

int main() {
    std::cout << "输入两个值" << std::endl;
    int input1;
    int input2;
    std::cin >> input1 >> input2;
    std::cout << "两个值的和为: " << input1 + input2;
    return 0;
}
运行结果为:
输入两个值
12
13
两个值的和为: 25
Process finished with exit code 0
-
include "iostream" : 告诉编译器我们想使用iostream库。
iostream指出了一个头文件(header),每个使用标准库设施的程序都必须包含相应的头文件。
#include <头文件的文件名>    //要包含的头文件位于编译环境的默认路径下

#include "头文件的文件名"     //要包含的头文件与程序代码位于相同的路径下
随着C++的不断演化,不同的编译器厂商选用了不同的文件扩展名。而且,不同的操
作系统对文件名有不同的限制,特别是对文件名长度限制。
结果引起了对源代码的可移植性的限制。为了消除这些差别,标准使用的格式允许文件名长度可以大于众所周知的8个字符,去除了扩展名。例如,代替老式的包含iostream.h的语句
#include <iostream.h>
现在可以写成:
#include <iostream>
- 输出运算符<<
<< 运算符左侧的运算对象必须是一个ostream对象,右侧的运算对象是要打印的值。
运算符将给定的值写到给定的ostream对象中。我们的输出语句使用了两次<<运算符。
因为此运算符返回其左侧的运算对象(本例中是std::cout),因此第一个运算符的结果成为了第二个运算符的左侧运算对象。这样我们就可以将输出请求连接起来。 - 操纵符(manipulator) endl
写入endl的效果是结束当前行,并将与设备关联的缓冲区(buffer)中的内容刷到设备中。
缓冲刷新操作可以保证到目前为止程序所产生的所有输出都真正写入输出流中,而不是仅停留在内存中等待写入流。 -
命名空间(namespace)
上面的程序中使用了std::cout和std::endl,而不是直接使用cout和endl。前缀std::指出名字cout和endl是定义在名为std的命名空间中的。
命名空间可以帮助我们避免不经意的名字定义冲突,以及使用库中相同名字导致的冲突。标准库定义的所有名字都在命名空间std中。
通过命名空间使用标准库的一个副作用:当使用标准库中的一个名字时,必须显式说明我们想使用来自命名空间std中的名字。例如,需要写出std::cout,通过使用作用域运算符(::)来指出我们想使用定义在命名空间std中的名字cout。
命名空间还可以定义成匿名的,即创建命名空间时不写名字,由系统自动分配。例如,下面定义的命名空间就是匿名的。c++ namespace { // .... }编译器在编译阶段会为匿名命名空间生成唯一的名字,这个名字是不可见的。除此之外,编译器还会为这个匿名命名空间生成一条using指令。编译后的匿名命名空间等效于下面的代码:
c++
namespace _UNIQUE_NAME_ {
    // ....
}
using namespace _UNIQUE_NAME_
匿名命名空间的作用是限制命名空间的内容仅能被当前源文件使用,其他源文件是无法访问的,使用extern声明访问也是无效的。
控制流
- while
- for
- if
基本内置类型
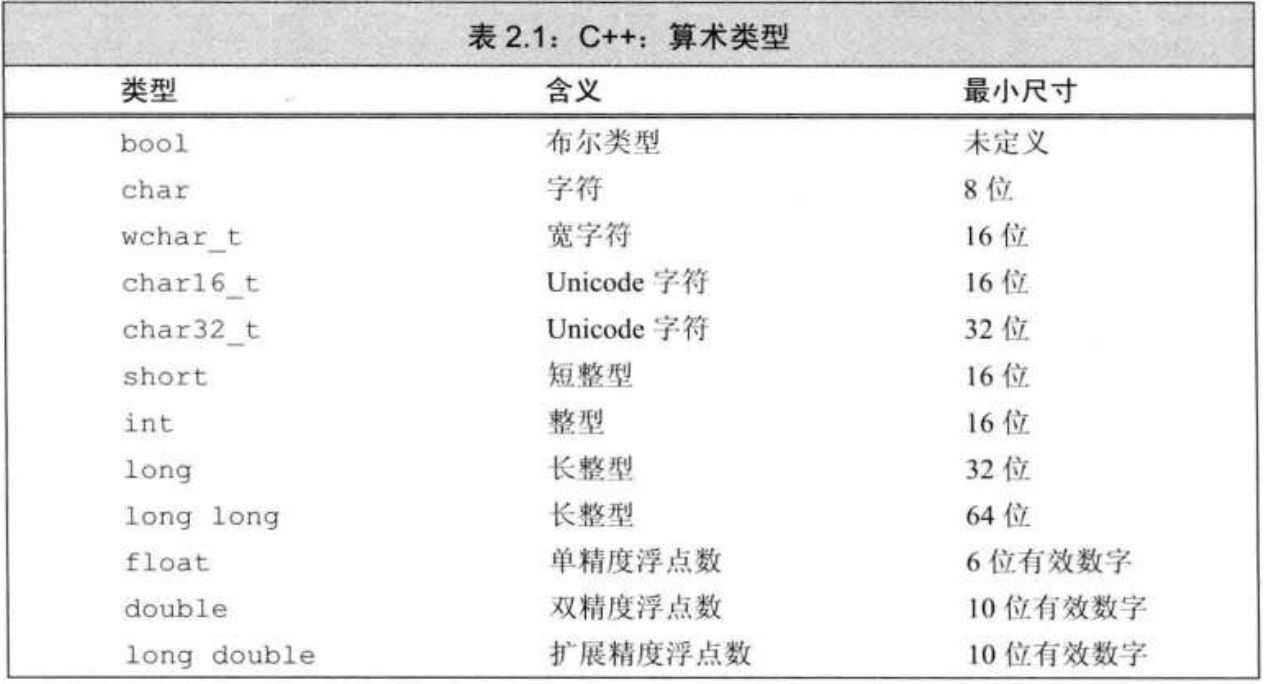
C++定义了一套包含算数类型(arithmetic type)和空类型(void)在内的基本数据类型,其中算数类型包含了字符、整型数、布尔值和浮点数。空类型不对应具体的值。
变量声明
声明(declaration)和定义(definition)这两个术语必须弄清它们之间的区别。
事实上,所有的C/C++程序都要求声明。编写第一个程序之前,需要了解声明的基本方法。
- 声明是向编译器介绍名字—标识符。它告诉编译器“这个函数或这个变量在某处可找到,它的模样像什么”。
- 而定义是说:“在这里建立变量”或“在这里建立函数”。它为名字分配存储空间。无论定义的是函数还是变量,编译器都要为它们在定义点分配存储空间。
对于变量,编译器确定变量的大小,然后在内存中开辟空间来保存变量的数据。对于函数,编译器会生成代码,这些代码最终也要占用一定的内存。
对“变量声明”的解释向来很模糊且自相矛盾,而理解它准确的含义对于正确的理解定义和阅读程序十分重要。变量声明告知编译器变量的外表特征。
这好像是对编译器说:“我知道你以前没有看到过这名字,但我保证它一定在某个地方,它是X类型的变量。
变量的声明为:
extern int a;  // 声明a而非定义a
int j;         // 声明并定义j

// 任何包含了显式初始化的声明即成为定义。我们能给由extern关键字标识的变量赋一个初始值,但是这么做就抵消了extern的作用。
// extern语句如果包含初始值就不再是声明,而变成定义了
extern double pi = 3.1416; // 定义
可以声明变量a是一个整数,这符合上面的逻辑。但这就产生了一个矛盾:这段代码有足够的信息让编译器为整数a分配空间,而且编译器也确实给整数a分配了空间。
要解决这个矛盾,对于C/C++需要一个关键字来说明“这只是一个声明,它的定义在别的地方”。
这个关键字就是extern,它表示变量是在文件以外定义的,或在文件后面部分才定义。
在变量定义前加extern关键字表示声明一个变量但不定义它,例如:
extern int a;
同样,extern也可以用于函数声明。例如:
extern int func1(int lenght, int width);
在分配好内存空间后且程序尚没有运行前,变量会被分配一个不可知的混乱值。
如果程序中没有对其进行赋值就使用,势必会引起不可预期的结果。因此使用变量前,务必对其进行初始化,而且只有变量的数据类型相同时,才可以在一个语句中进行初始化。
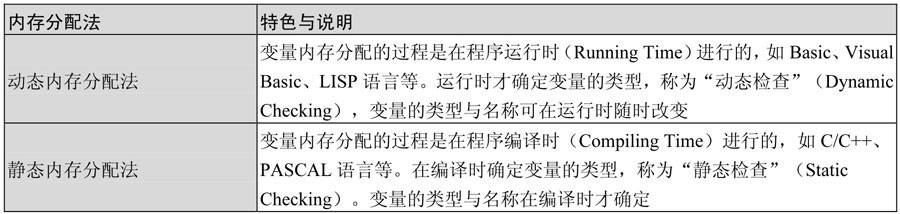
在程序设计语言中,有关变量存储地址的方法有两种,由于C++是属于“静态内存分配”(static storage allocation,或称为静态存储器分配)的程序设计语言,必须在编译时分配内存空间给变量,因此变量一定要事先声明后才可以使用。
基本上,完整C++的变量声明方式是由数据类型加上变量名称与分号三部分所构成的。
另外,变量设置值可分为两种方式:声明后再设置值与声明时设置值。至于变量初始化,最好是在变量一开始声明时就指定初值,否则很容易出现一些不可预期的情况。
变量能且只能被定义一次,但是可以被多次声明。
声明和定义的区别看起来也许微不足道,但实际上却非常重要。如果要在多个文件中使用同一个变量,就必须将声明和定义分离。此时,变量的定义必须出现且只能出现在一个文件中,而其他用到该变量的文件必须对其进行声明,却绝对不能重复定义。在函数体内部,如果试图初始化一个由extern关键字标识的变量,将引发错误。
C++提供了5种变量等级“类型修饰词”(type modifier),包括auto、static、extern、static extern与register。
局部变量是指限制在某一范围内使用的变量。局部变量经常被称为自动变量,是因为它在进入作用域时自动生成,采用堆栈方式分配内存空间,离开作用域时释放内存空间,值也自动消失。关键字auto可以显式地说明这个问题,但是局部变量默认为auto,所以没有必要声明为auto。
全局变量是在所有函数体的外部定义的,程序的所有部分(甚至其他文件中的代码)
都可以使用。
全局变量不受作用域的影响,总是可用的(也就是说,全局变量的生命周期一直到程序的结束)。
如果在一个文件中使用extern关键字来声明另一个文件中存在的全局变量,那么这个文件可以使用这个数据。例如:
Global.cpp
#include <iostream>
using namespace std;
int globe;
int main() {
    globe = 12;
}
下面的程序把globe作为一个外部变量来访问:
Global2.cpp
extern int globe;
void func() {
    globe = 47;
}
变量globe的存储空间是由程序Global.cpp中的定义创建的,在Global2.cpp的代码中可以访问同一个变量。
由于Global2.cpp和Global.cpp的代码是分段编译的,必须通过声明:
extern int globe;
告诉编译器变量存在哪里。
extern c的作用
有时候会经常在C和C++中进行相互调用。
在实际项目中,如果一个C++工程需要调用C语言编写的静态库或者动态库,那么可以直接调用吗?
显然是不可以直接调用的,对于C++代码,因为C++有自己的函数名修饰规则,在编译和汇编阶段形成符号表的时候,编译器是按照C++自己的函数名修饰规则来表示符号的,而对于C的代码,也有自己的函数名修饰规则,在编译和汇编阶段,编译器是按照C的函数名修饰规则来形成符号表的,那么在链接阶段,由于符号表中表示同一函数的符号名都是不同的,链接器无法找到相应函数的地址,也就无法进行符号表的合并和重定位,就会产生链接错误。
同理,一个C工程要调用C++语言编写的静态库或者动态库,也是不可以直接调用的。
那么一个C++工程如何调用C语言编写的代码呢?一个C工程又如何调用C++语言编写的代码呢?
这实际上是一个代码可移植问题,这里就需要用到条件编译和extern "C"了。
C语言中并没有重载和类这些特性,故并不像C++那样print(int i),会被编译为_print_int,而是直接编译为_print等。因此如果直接在C++中调用C的函数会失败,因为连接是调用C中的 print(3)时,它会去找_print_int(3)。因此extern "C"的作用就体现出来了。
如果在C++中编写一个程序需要用到C的库,那该怎么办呢?如果这样声明一个C函数:
float f(int a, char b);
C++的编译器就会将这个名字变成像_f_int_char之类的东西以支持函数重载(和类型安全连接),而C中是不支持函数重载的,所以不会修改函数的名字。
然而,C编译器编译的库一般不做这样的转换,所以它的内部名为_f。这样,连接器无法解释C++对f()的调用。
C++中提供了一个替代连接说明(alternate linkage specification),它是通过重载extern关键字来实现的。
extern后跟一个字符串来指定想声明的函数的连接类型,后面是函数声明。
extern "C" float f(int a, char b);
这就告诉编译器f()是C连接,这样就不会转换函数名。
标准的连接类型指定符有"C"和"C++"两种,如果有一组替代连接的声明,可以把它们放在花括号内:
extern "C" {
    float f(int a, char b);
    double d(int a, char b);
}
或在头文件中:
extern "C" {
    #include "Myheader.h"
}
寄存器变量是一种局部变量。关键字register告诉编译器“尽可能快地访问这个变量”。
加快访问速度取决于实现,但是,正如名字所暗示的那样,这经常是通过在寄存器中放置变量来做到的。
这并不能保证将变量放置在寄存器中,甚至也不能保证提高访问速度。这只是对编译器的一个暗示。
使用register变量是有限制的。不可能得到或计算register变量的地址。register变量只能在一个块中声明(不可能有全局的或静态的register变量)。
然而可以在一个函数中(即在参数表中)使用register变量作为一个形式参数。
一般地,不应当推测编译器的优化器,因为它可能比我们做得更好。因此,最好避免使用关键字register。
关键字static有一些独特的意义。通常,函数中定义的局部变量在函数作用域结束时消失。
当再次调用这个函数时,会重新创建该变量的存储空间,其值会被重新初始化。如果想使局部变量的值在程序的整个生命期里仍然存在,我们可以定义函数的局部变量为static(静态的),并给它一个初始值。
初始化只在函数第一次调用时执行,函数调用之间变量的值保持不变。用这种方式,函数可以“记住”函数调用之间的一些信息片断。
我们可能奇怪为什么不使用全局变量。static变量的优点是在函数范围之外它是不可用的,所以它不可能被轻易地改变。这会使错误局部化。
下面是一个使用static变量的例子:
#include <iostream>
using namespace std;
void func() {
    static int i = 0;
    cout << "i = " << ++i << endl;
}
int main() {
    for (int x = 0; x < 10; x++)  {
        func();
    }
}
每一次在for循环中调用函数func()时,它都打印不同的值。如果不使用static,打印出的值总是‘1’。
static的第二层意思和前面的含义相关,即“在某个作用域外不可访问”。当应用static于函数名和所有函数外部的变量时,它的意思是“在文件的外部不可以使用这个名字”。
函数名或变量是局部于文件的;我们说它具有文件作用域(file scope)。例如,编译和连接
下面两个文件会引起链接器错误:
FileStatic.cpp
static int fs;
int main() {
    fs = 1;
}
尽管在下面的文件中变量fs被声明为extern,但是连接器不会找到它,因为在FileStatic.cpp中它被声明为static。
FileStatic2.cpp
extern int fs;
void func() {
    fs = 100;
}
外部变量: 前面已经简要地描述和说明了extern关键字。它告诉编译器存在着一个变量和函数, 即使编译器在当前编译的文件中没有看到它。这个变量或函数可能在另一个文件中或者在当前文件的后面定义
当编译器遇到‘extern int i’时,它知道i肯定作为全局变量存在于某处。当编译器看到变量i的定义时,并没有看到别的声明,所以知道它在文件的前面已经找到了同样声明的i。
如果已经把变量i定义为static,又要告诉编译器,i是全局定义的(通过extern),但是,它也有文件作用域(通过static),所以编译器会产生错误。
布尔类型 bool
作用:布尔数据类型代表真或假的值
bool类型只有两个值:
- true --- 真(本质是1)
- false --- 假(本质是0)
bool类型占1个字节大小
示例:
int main() {
    bool flag = true;
    cout << flag << endl; // 1

    flag = false;
    cout << flag << endl; // 0

    cout << "size of bool = " << sizeof(bool) << endl; //1

    system("pause");

    return 0;
}
函数声明
通常C++的程序员习惯会将主程序main()函数编写在程序文件的最前端,以突显程序的主要逻辑。
不过,C++的编译程序是从上往下解析程序代码的内容,如果在主程序main()函数里调用了自定义函数,却将自定义函数定义在main()函数的后方,那么编译程序会出现错误信息。
也就是说,调用函数的程序代码位于自定义函数定义之后就不需要事先声明了。如果调用函数的程序代码位于自定义函数定义之前就必须在尚未调用函数前先行声明自定义函数的原型(function prototype),以便告诉编译程序有一个还没有定义却将会用到的自定义函数存在。
和其他名字一样,函数的名字也必须在使用之前声明。类似于变量,函数只能定义一次,但可以声明多次。
函数的声明和函数的定义非常类似,唯一的区别是函数声明无需函数体,用一个分号替代即可。
因为函数的声明不包含函数体,所以也就无需形参的名字。事实上,在函数的声明中经常省略形参的名字。
尽管如此,写上形参的名字还是有用处的,它可以帮助使用者更好的理解函数的功能。
函数的三要素(返回类型、函数名、形参类型)描述了函数的接口,说明了调用该函数所需的全部信息。
函数声明也称作函数原型(function prototype)。
前面说到建议变量在头文件中声明,在源文件中定义。与之类似,函数也应该在头文件中声明而在源文件中定义。
看起来把函数的声明直接放在使用该函数的源文件中是合法的,也比较容易被人接受,但是这么做可能会很繁琐而且容易出错。
相反,如果把函数声明放在头文件中,就能确保同一函数的所有声明保持一致。而且一旦我们想改变函数的接口,只需改变一条声明即可。
定义函数的源文件应该把含有函数声明的头文件包含进来,编译器负责验证函数的定义和声明是否匹配。
复合类型
复合类型(compound type)是指基于其他类型定义的类型。C++语言由几种符合类型,下面先介绍其中的两种:引用和指针。
引用(引用即别名)
作用: 给变量起别名
语法: 数据类型 &别名 = 原名
- 引用必须初始化
- 引用在初始化后,不可以改变
引用类型(reference)在C++中是一种很特别的类型,和指针有点相似,可以用来为变量、常数或对象取“别名”(alias)。
一旦使用某个标识符为变量、常数或对象取了别名,就可以使用该标识符来引用同一个变量、常数或对象。
引用类型的重要特征就是一旦对变量或对象(假设是B)取了别名(假设是A)后,那么所有作用于A的运算处理所产生的效果就都会累积到B身上,如同直接对B进行运算处理一样。
引用(reference)为对象起了另外一个名字,引用类型引用(refers to)另外一种类型。通过将声明符写成&d的形式来定义引用类型,其中d是声明的变量名:
int ival = 1024;
int &refVal = ival;   // refVal指向ival(是ival的另一个名字)
int &refVal2;         // 报错,引用必须被初始化
refVal = 2;           // 把2赋值给refVal指向的对象,此处即是赋值给了ival
int ii = refVal;      // 与 ii == ival执行结果一样
int &refVal4 = 10;    // 错误:引用类型的初始值必须是一个对象
double dval = 3.14;
int &refVal5 = dval;  // 错误:此处引用类型的初始值必须是int型对象,这里是double型
一般在初始化变量时,初始值会被拷贝到新建的对象中。
然而定义引用时,程序把引用和它的初始值绑定(bind)在一起,而不是将初始值拷贝给引用。
一旦初始化完成,引用将和它的初始值对象一直绑定在一起。因为无法令引用重新绑定到另外一个对象,因此引用必须初始化。
引用并非对象,相反的,它只是为一个已经存在的对象所起的另外一个名字。
int rats;
int &rodents = rats;
这个引用声明允许将rats和rodents互换,它们指向相同的值和内存单元。
函数返回引用
accumulate(team, two);
free_throws &accumulate(free_thorws& target, const free_throws& source) {
    return target;
}
如果上面的函数返回类型被声明为free_throws而不是free_throws&, 上述返回语句将返回target(也就是参数传入的team)的拷贝。 但是返回类型是引用,这意味着返回的是最初传递给accumulate()的team对象。
那么为什么要返回引用呢?
传统返回机制与按值传递函数参数类似:计算关键字return后面的表达式,并将结果返回给调用函数。
从概念上说,这个值被复制到一个临时位置,而调用程序将使用这个值,例如:
double m = sqrt(16.0);
cout << sqrt(25.0);
在第一条语句中结果值4.0被复制到一个临时位置,然后被复制给m。
在第二条语句中结果值5.0被复制到一个临时位置,然后被传递给cout。
所以如果上面的accumulate()函数返回一个结构,而不是指向结构的引用,将把整个结构复制到一个临时位置,再将这个拷贝复制给另一个变量。
但是在返回值为引用时,将直接把team复制给另一个变量,其效率更高。
然而,并不总是可以返回引用。函数不能返回在函数中创建的临时对象的引用,因为当函数结束时,临时对象将消失,因此这种引用将是非法的。在这种情况下,应返回对象,以生成一个调用程序可以使用的副本。
通用的规则是,如果函数返回在函数中创建的临时对象,则不要使用引用。
如果函数返回的是通过引用或指针传递给它的对象,则应按引用返回对象。
引用作用域数组
int arr[5] = {1, 2, 3, 4, 5};
// 引用作用于数组
// 直接将数组名,替换为 &otherName, 但是因为[]的优先级更高,所以需要加上小括号
int (&arr1)[5] = arr;

// 方法2:先给数组类型起一个别名,例如这里给int[5]的数组起一个为TYPE_ARR的别名
typedef int TYPE_ARR[5];
// TYPE_ARR newArr = {1, 2, 3, 4, 5};
// 再给这个数组类型的别名来设置引用
TYPE_ARR &myArr = arr;

for(int i = 0; i < 5; i++) {
    std::cout << arr1[i] << std::endl;
}

for(int i = 0; i < 5; i++) {
    std::cout << myArr[i] << std::endl;
}
指针(pointer)
指针是指向(point to)另外一种类型的复合类型。
与引用类似,指针也实现了对其他对象的间接访问。然而指针与引用相比又有很多不同点:
- 指针本身就是一个对象,允许对指针赋值和拷贝,而且在指针的声明周期内它可以先后指向几个不同的对象。
- 指针无须在定义时赋值。和其他内置类型一样,在块作用域内定义的指针如果没有被初始化,也将拥有一个不确定的值。
定义指针类型的方法将声明符写成*d的形式,其中d是变量名。
int *ip1, *ip2; // ip1和ip2都是指向int型对象的指针
指针存放某个对象的地址,要想获取该地址,需要使用取地址符(&):
int ival = 42;
int *p = &ival; // p存放变量ival的地址,或者说p是指向变量ival的指针
因为引用不是对象,没有实际地址,所以不能定义指向引用的指针。
空指针(null pointer)不指向任何对象,在试图使用一个指针前代码可以先检查它是否为空。得到空指针最直接的办法是用字面值nullptr来初始化指针。
旧版本程序通常使用NULL(预处理变量,定义于头文件cstdlib中,值为0)给指针赋值,但在C++11中,最好使用nullptr初始化空指针。
void* 指针
如果声明指针是void*,它意味着任何类型的地址都可以间接引用那个指针(而如果声明int*,则只能对int型变量的地址间接引用那个指针)。
例如:
int main() {
    void* vp;
    char c;
    int i;

    vp = &c;
    vp = &i;
}
一旦我们间接引用一个void*,就会丢失关于类型的信息。这意味着在使用前,必须转换为正确的类型:
int main() {
   int i = 99;
   void* vp = &i;
   ((int*)vp) = 3;
}
转换(int*)vp告诉编译器把void*当做int*处理,因此可以成功地对它间接引用。
这个语法很难看,的确如此,但是更糟的是,void*在语言类型系统中引入了一个漏洞。
也就是说,它允许甚至是提倡把一种类型看做另一种类型。在上面的例子中,通过把vp转换为int*,把一个整型看做是一个整型,但是,并没有说不能把它转换为一个char*或double*,这将改变已经分配给int的存储空间的大小,可能会引起程序崩溃。
一般来说,应当避免使用void指针,只有在一些少见的特殊情况下才用。
利用指针访问对象
如果指针指向了一个对象,则允许使用解引用符(*)来访问该对象:
int ival = 42;
int *p = &ival;
cout << *p;      // 由符号*得到指针p所指向的对象,输出42
对指针解引用会得出所指的对象,因此如果给解引用的结果赋值,实际上也就是给指针所指的对象赋值:
*p = 0;       //由符号*得到指针p所指的对象,即可经由p为变量ival赋值
cout << *p;   //输出0
如上程序所示,为*p赋值实际上是为p所指向的对象赋值。
函数的指针
声明指向某种数据类型的指针时,必须指定指针指向的类型。
同样,声明指向函数的指针时,也必须指定指针指向的函数类型。
这意味着声明应指定函数的返回类型以及函数的特征(参数列表)。
也就是说声明应像函数原型那样指出有关函数的信息。例如一个函数的原型如下:
double pam(int);  // 原型
// 则正确的指针类型应该如下
double (*pf)(int);
这与pam()声明类似,这是将pam替换成了(*pf)。
由于pam是函数,因此(*pf)也是函数。
通常要声明指向特定类型的函数的指针,可以首先编写这种函数的原型,然后用(*pf)替换函数名。这样pf就是这类函数的指针。
使用指针来调用函数
上面讲过(*pf)扮演的角色与函数名相同,因此使用(*pf)时,只需要将它看作函数名即可:
double pam(int);
double (*pf)(int); // pf现在指向了pam()函数
double x = pam(4);  // 使用函数名调用
double y = (*pf)(5);  // 使用函数的指针调用

double z = pf(5);    // C++也允许像使用函数名那样使用pf,同样也是通过函数的指针调用
获取函数的地址很简单:只要使用函数名(后面不跟参数)即可。
也就是说,如果think()是一个函数,则think就是该函数的地址。
要将函数作为参数进行传递,必须传递函数名。
&与*
像&与*这样的符号,既能用作表达式里的运算符,也能作为声明的一部分出现,符号的上下文决定了符号的意义:
int i = 42;
int &r = i;     // &紧随类型名出现,因此是声明的一部分,r是一个引用
int *p;         // *紧随类型名出现,因此是声明的一部分,p是一个指针
p = &i;         // &出现在表达式中,是一个取地址符
*p = i;         // *出现在表达式中,是一个解引用符
int &r2 = *p;   // &是声明的一部分, *是一个解引用符
引用本身不是一个对象,因此不能定义指向引用的指针。
但指针是对象,所以存在对指针的应用:
int i = 42;
int *p;
int *&r = p; // r是一个对指针p的引用
r = &i;      // r引用了一个指针,因此给r复制&i就是令p指向i
要理解r的类型到底是什么,最简单的办法就是从右向左阅读r的定义。
离变量名最近的符号(此例中是&r的符号&)对变量的类型有最直接的影响,因此r是一个引用。
声明符的其余部分用以确定r引用的类型是什么,此例中的符号*说明r引用的是一个指针。最后,声明的基本数据类型部分指出r引用的是一个int指针。
引用与指针
引用的本质:引用的本质在c++内部实现是一个指针常量。
c++推荐用引用技术,因为语法方便,引用的本质是指针常量,但是所有的指针操作编译器都帮我们做了。
常量
C++定义常量有两种方式:
#define宏常量:#define 常量名 常量值- 通常在文件上方定义,表示一个常量
- const修饰的变量: const 数据类型 常量名 = 常量值
- 通常在变量定义前加关键字const,修饰该变量为常量,不可修改
尽量以const、enum、inline替换#define
const 限定符
有时候希望定义这样一种变量,它的值不能被改变,为了满足这一要求,可以用关键字const对变量类型加以限定:
const int bufSize = 512;
因为const对象一旦创建后其值就不能再改变,所以const对象必须初始化。
默认情况下,const对象仅在文件内有效,编译器在编译过程中会把用到该常量的地方都替换成对应的值,也就是说,编译器会找到代码中所有用到bufSize的地方,然后用512替换。
为了执行上述替换,编译器必须知道变量的初始值。如果程序包含了多个文件,则每个用了const对象的文件都必须得能访问到它的初始值才行。要做到这一点,就必须在每一个用到常量的文件中都有对它的定义。
为了支持这一用法,同时避免对同一常量的重复定义,默认情况下const对象被设定为仅在文件内有效。当多个文件中出现了同名的const变量时,其实等同于在不同文件中分别定义了独立的变量。
某些时候有这样一种const变量,它的初始值不是一个常量,但又确实有必要在文件间共享。
这种情况下,我们不希望编译器为每个文件分别生成独立的常量。
相反我们想让这类const对象像其他(非常量)对象一样工作,也就是说,只在一个文件中定义const,而在其他多个文件中声明并使用它。
解决的办法是,对于const变量不管是声明还是定义都添加extern关键字,这样只需定义一次就可以了:
// file_1.cc定义并初始化了一个常量,该常量能被其他文件访问
extern const int bufSize = fcn();
// file_1.h头文件
extern const int bufSize;  // 与file_1.cc中定义的bufSize是同一个
如上,file_1.cc定义并初始化了bufSize。因为这条语句包含了初始值,所以他是一次定义。
然而,因为bufSize是一个常量,必须用extern加以限定使其被其他文件使用。
file_1.h头文件中的声明也由extern做了限定,其作用是指明bufSize并非本文件所独有,它的定义将在别处出现。
const引用
const引用是指向const对象的引用。
const int ci = 1024;
const int &r1 = ci; // 正确:引用及其对应的对象都是常量
int &ref2 = ci;     // 错误:const对象的引用必须是const引用
void Start::show() const {...}
这里的const表示const Start* this,而this指向调用的对象。
还可以将返回引用的函数放在赋值语句的左侧,这实际上意味着可以将值赋值给引用的对象。但可以使用const来确保引用或指针返回的值不能用于修改对象的数据:
const Stock& Stock::topval(const Stock& s) const {
    if (s.total_val > total_val) {
        return s;
    } else {
        return *this;
    }
}
该方法返回对this或s的引用。因为this和s都被声明为const,所以函数不能对他们进行修改,这意味着返回的引用也必须被声明为const。
注意,如果函数将参数声明为指向const的引用或指针,则不能将该参数传递给另一个函数,除非后者也确保了参数不会被修改。
const修饰方法或对象
const修改函数时可以构成重载。
void dis() const;

void dis();
- const修饰函数,是从函数的层面,该函数内部不能修改成员数据。
- const修饰对象,是从对象层面不修改数据,只能调用const成员函数。const对象只能调用const成员函数。非const成员对象,优先调用非const成员函数,若无,则可调用const成员函数。
指针和const
与引用一样,也可以令指针指向常量或非常量。
指向常量的指针(pointer to const)不能用于改变其所指对象的值。要想存放常量对象的地址,只能使用指向常量的指针:
const double pi = 3.14;
double *ptr = π        // 错误:ptr是一个普通指针
const double *cptr = π // 正确: cptr可以指向一个常量
*cptr = 42;               // 错误:不能给常量指针*cptr赋值
从标识符开始读,cptr是一个指针,它指向一个const double。
指向常量的指针(const修饰指针)
int a = 10;
int b = 10;
// 常量指针:这里看指针的指向可以修改,但是指针指向的值不可以改
// 这里p是一个什么类型的指针? p是一个const int类型,也就是说p是一个指向常量的指针,指向的是一个常量,常量是不能修改的。
const int* p = &a;
*p = 20; // 错误,指针指向的是一个常量值,值不可以改
p = &b;  // 正确,指针可以改
指针常量
// p还是一个int *类型的指针,所有他指向的值是一个int类型的值,是可以修改的
int * const p = &a;  //指针的指向不可以改,但是指针指向指向的值可以改
*p = 20;  // 正确,指向的值可以改
p = &b;   // 错误,指针指向不可以改
一个简单的记法就是:
int * const p = &a;,那const修饰的是p,也就是指针是不能修改的。那p就是一个常量,常量是必须要初始化的。
const即修饰指针,又修饰常量
const int * const p = &b; // 指针的指向和指针指向的值都不可以改
vector
标准库类型vector表示对象的集合,其中所有对象的类型都相同。集合中的每个对象都有一个与之对应的索引,索引用于访问对象。
因为vector容纳着其他对象,所以它也常被称作为容器(container)。
#include "iostream"
#include "vector"

int main() {
    std::vector<int> ivec;
    const int size = 10;
    // 第一个循环添加元素
    for (int i = 0; i < size; ++i) {
        ivec.push_back(i);
    }
    // 第二个循环把控制变量i定义成引用类型,这样就能通过i给ivec的元素赋值
    for (auto &i : ivec) {
        i = i + 100;
    }

    for (auto i : ivec) {
        std::cout << i << std::endl;
    }
    return 0;
}
运行结果:
100
101
102
103
104
105
106
107
108
109
数组
数组是一种类似于vector的数据结构。
int yams[3];

int yamcosts[3] = {20, 30, 5};
C++11将使用大括号的初始化作为一种通用的初始化方式,可用于所有类型。
初始化数组时,可省略等号,也可以不在大括号中包含任何信息,这将把所有元素都设置为零:
unsigned int counts[10] = {};  // 所有元素都是0
int balances[4] {1, 2, 3, 4}
C++将数组名解释为其第一个元素的地址:
counts == &counts[0];
数组名与指针对应是好事吗?
确实是一件好事。将数组地址作为参数可以节省复制整个数组所需的时间和内存。
如果数组很大,则使用拷贝的系统开销将非常大。程序不仅需要更多的计算机内存,还需要花费时间来复制大块的数据。
- 与vector相似的地方是,数组也是存放类型相同的对象的容器,这些对象本身没有名字,需要通过其所在位置访问。
- 与vector不同的地方是,数组的大小确定不变,不能随意向数组中增加元素。因为数组的大小固定,因此对某些特殊的应用来说程序的运行时效能较好,但是相应地也损失了一些灵活性。
数组的指针就是第一个元素。
使用指针和数组很容易出错。一部分原因是概念上的问题:
指针常用于底层操作,因此容易引发一些繁琐细节有关的错误。其他问题则源于语法错误,特别是声明指针时的语法错误。
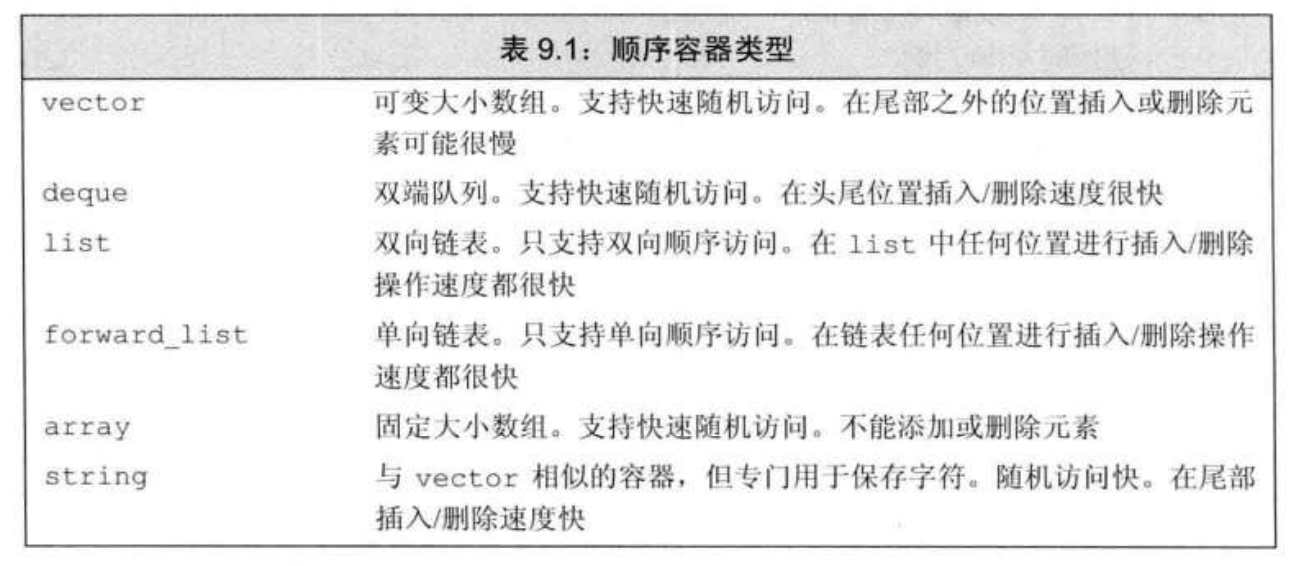
现代的C++程序应当尽量使用vector和迭代器,避免使用内置数组和指针。应该尽量使用string,避免使用C风格的基于数组的字符串。
字符串型
作用:用于表示一串字符
两种风格
- C风格字符串:
char 变量名[] = "字符串值"
示例:
```C++ int main() {
char str1[] = "hello world";
cout << str1 << endl;

system("pause");

return 0;
} ```
注意:C风格的字符串要用双引号括起来
- C++风格字符串:
string 变量名 = "字符串值"
示例:
```C++ int main() {
string str = "hello world";
cout << str << endl;

system("pause");

return 0;
} ```
注意:C++风格字符串,需要加入头文件#include
。而且string类在命名空间std中,因此要用using指令或者通过std::调用。
字符串声明最重要的特点是必须使用空字符('\0')来代表每一个字符串的结束例如’a'与"a"分别代表字符常数和字符串常数,其中’a’的长度为1, "a"的长度为 对于用双引号括起来的字符串常量,C++语言编译系统会自动在后面加上一个字符串结束标志'\0'。因此,数组str[]在内存中的实际长度是12。
内联函数
通常一般程序在进行函数调用前会先将一些必要信息(如调用函数的地址、传入的参数等)保留在堆栈中,以便在函数执行结束后可以返回原先调用函数的程序继续执行。
因此,对于某些频繁调用的小型函数来说,这些堆栈存取操作会减低程序的执行效率,此时即可运用内联函数来解决这个问题。
所谓C++的内联函数(inline function),就是当程序中使用到关键字inline定义的函数时,C++会将调用inline函数的部分,直接替换成inline函数内的程序代码,而不会有实际的函数调用过程。
如此一来将可以省下许多调用函数所花费的时间,同时减少主控权转换的次数,提高程序的执行效率。
函数的参数传递
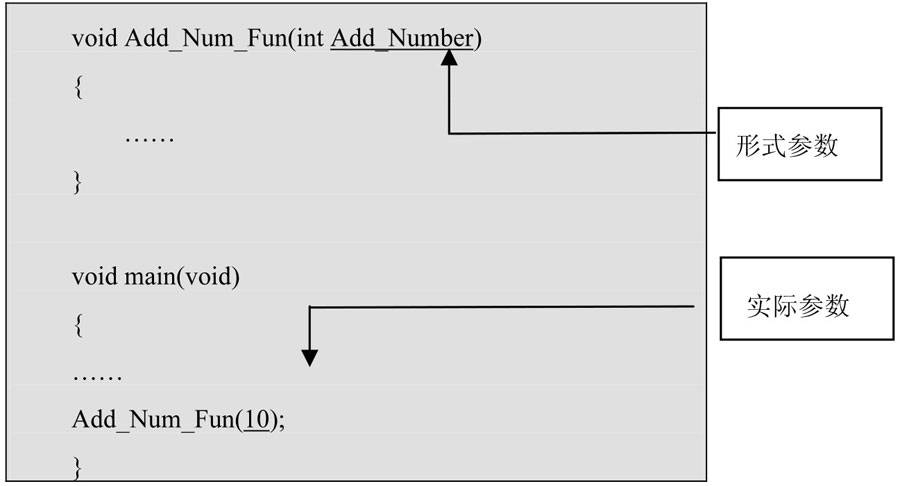
带参函数中的参数在函数声明和定义时被称为形式参数,简称形参。
在函数被调用时被赋予具体值,具体的值被称为实际参数,简称实参。
在C++中,对于传递参数的方式,其实可以根据传递和接收的是参数数值还是参数地址分为三种:
- 传值调用(call by value)
- 传址调用(call by address)
- 传引用调用(call by reference)
向函数传递参数的传值调用方法是把参数的实际值复制给函数的形式参数。在这种情况下,修改函数内的形式参数不会影响实际参数。
默认情况下,C++使用传值调用方法来传递参数。一般来说,这意味着函数内的代码不会改变用于调用函数的实际参数。
和其他变量一样,形参的类型决定了形参和实参的交互方式。如果形参是引用类型,它将绑定到对应的实参上。否则将实参的值拷贝后赋值给形参。
当形参是引用类型时,我们说它对应的实参被引用传递(passed by reference)或者函数被传引用调用(called by reference)。
和其他引用一样,引用形参也是它绑定的对象的别名。也就是说,引用形参是它对应的实参的别名。
当实参的值被拷贝给形参时,形参和实参是两个相互独立的对象。
我们说这样的实参被值传递(passed by value)或者函数被传值调用(called by value)。
当初始化一个非引用类型的变量时,初始值被拷贝给变量。此时,对变量的改动不会影响原始值:
int n = 0;
int i = n;
i = 42;  // i的值改变,n的值不变
传值参数的机理完全一样,函数对形参做的所有操作都不会影响实参。
所谓传值调用(call by value),是指主程序调用函数的实际参数时系统会将实际参数的数值传递并复制给函数中相对应的形式参数。
由于函数内的形式参数已经不是原来的变量(形式参数是额外分配的内存),因此在函数内的形式参数执行完毕时并不会修改原先主程序中调用时变量自身的内容。
通常,向函数传递参数时,在函数内部生成该参数的一个拷贝。这称为按值传递(pass-by-value)。在下面的程序中能看到按值传递的效果:
#include <iostream>
using namespace std;

void f(int a) {
    cout << "a = " << a << endl;
    a = 5;
    cout << "a = " << a << endl;
}

int main() {
    int x = 47;
    f(x);
    cout << "x = " << x << endl;
}
在函数f()中,a是一个局部变量(local variable),它只有在调用函数f()期间存在。
因为它是一个函数参数,所以调用函数时通过参数传递来初始化a的值;在main()中参数是x,其值为47,所以当调用函数f()时,这个值被拷贝到a中。
当然,最初,x的值是47。调用f()时,在函数调用期间为变量a分配临时空间,拷贝x的值给a来初始化它,当然,我们可以改变a的值并显示它被改变。但是f()调用结束时,分配给a的临时空间就消失了,我们可以看到,在a和x之间的曾经发生过的惟一联系,是在把x的值拷贝到a的时候。
函数的传址调用(call by address)表示在调用函数时系统并没有分配实际的地址给函数的形式参数,而是将实际参数的地址直接传递给所对应的形式参数。
如此函数的形式参数将与所传递的实际参数共享同一块地址,因此当函数内的形式参数执行完毕时将会通过指针方式指向实际参数的变量地址,更改原先调用函数内的变量内容。
也就是说,C++是以分配指针变量的形式参数来存放实际参数所传入的变量地址。实际上,也就是一种传递指针变量的功能。传引用方式也是类似于传址调用的一种,但是在传引用方式的函数中形式参数并不会另外分配内存来存放实际参数传入的地址,而是直接把形式参数作为实际参数的一个别名(alias)。
简单地说,传引用调用可以实现传址调用的类似功能,同时还具有传值调用的简便。在使用传引用调用时,只需要在函数原型和定义函数所要传递的参数前加上&运算符即可。
指针是C++语言中的一个重要概念,使用它可以操作内存数据的变量;引用是变量的别名。数组的首地址可以看作是指针,通过指针可以操作数组,指针和引用在函数的参数传递时可以相互替代。
指针形参
指针的行为和其他非引用类型一样。当执行指针拷贝操作时,拷贝的是指针的值。
拷贝之后,两个指针是不同的指针。因为指针使我们可以间接的访问它所指的对象,所以通过指针可以修改它所指对象的值。
int n = 0, i = 42;
int* p = &n, *q = &i;   // p指向n、q指向i
*p = 42;                // n的值改变,p不变
p = q;                  // 现在p指向了i,但是i和n的值都不变
定义一个指针时,必须规定它指向的变量类型。可以先给出一个类型名,然后不是立即给出变量的标识符,而是在类型和标识符之间插入一个星号,这就是说“等一等,它是一个指针”。一个指向int的指针如下所示:
int* ip;
引用传递
void reset(int &i) { // i是传递给reset函数的对象的另一个名字
    i = 0;
}

int j = 42;
reset(j);                         // j采用传递引用方式,它的值被改变
cout << "j = " << j << endl;      // 输出j = 0
在上述过程中,形参i仅仅是j的又一个名字。在reset内部对i的使用即是对j的使用。
拷贝大的类的类型对象或者容器对象比较低效,甚至有的类类型根本就不支持拷贝操作。当某种类型不支持拷贝操作时,函数只能通过引用形参访问该类型的对象。
举个例子,我们准备编写一个函数比较两个string对象的长度。因为string对象可能会非常长,所以应该尽量避免直接拷贝它们,这时使用引用形参是比较明智的选择。又因为比较长度无需改变string对象的内容,所以把形参定义成对常量的引用。
bool isShorter(const string &s1, const string &s2) {
    return s1.size() < s2.size();
}
引用形参绑定初始化它的对象。当调用这一版本的reset函数时,i绑定我们传递给函数的int对象,此时改变i也就是改变i所引对象的值。此例中,被改变的对象是传入reset的实参。
函数参数中的默认值
大家只需要在函数原型声明中设置变量的默认值即可,默认值的参数可以有多个,而且务必统一放置在参数行的尾端。理由很简单,因为C++编译程序会假设要省略的参数对应到参数行最右方的参数。注意,假如大家在函数定义时也设置了变量名称n的默认值,那么在编译程序时就会出现参数重复定义的错误。
函数的分文件编写
作用:让代码结构更加清晰
函数分文件编写一般有4个步骤:
- 创建后缀名为.h的文件
- 创建后缀名为.cpp的源文件
- 在头文件中写函数的声明
- 在源文件中写函数的实现
this指针
this指针指向被调用的成员函数所属的对象。
this指针是隐含每一个非静态成员函数内的一种指针,this指针不需要定义,直接使用即可。
this指针的用途:
- 当形参和成员变量同名时,可用this指针来区分
- 在类的非静态成员函数中返回对象本身,可使用return *this。
class Person {
    int age;
public:
    Person(int age) {
        this -> age = age;
    }

    Person& PersonAddPerson(Person p) {
        this -> age += p.age;
        return *this;
    }

}
类继承:
class RatedPlayer : public TableTennisPlayer {

}
冒号指出RatedPlayer类的基类是TableTennisplayer类。
上述特殊的声明头表明TableTennisPlayer是一个公有基类,这被称为共有派生。
派生类对象包含基类对象。使用共有派生,基类的公有成员将成为派生类的公有成员。基类的私有部分也将成为派生类的一部分,但只能通过基类的公有和保护方法访问。
私有继承
使用关键字private而不是public来定义类,实际上private是默认值,因此省略访问限定符也将导致私有继承。
使用私有继承,基类的公有成员和保护成员都将成为派生类的私有成员,这意味着基类方法将不会成为派生对象公有接口的一部分,但可以在派生类的成员函数中使用。
class Student : private A, private B {
    public:
    ....
}
静态属性及方法
#include <iostream>
using namespace std;
class Box {
    public:
        static int length;
        static int width;
        static int height;
        static int volume();
};
// static的属性不能在类内初始化,必须在类外初始化
int Box::length = 5;
int Box::width = 3;
int Box::height = 2;
int Box::volume() {
    return length * width * height;
}

int main() {
    cout << "volume" << Box::volume() << endl;
   return 0;
}
static在类内部用来实现类对象间的数据共享。在生成对象的时候,普通数据成员才有空间。
而static成员在类指明的时候就已经开辟了空间。
static数据成员,即属于类,也属于对象,但终归还是属于类。
- static变量初始化 类内定义,类外初始化。 type 类名::变量名=初始值
强制类型转换
(typeName)value;  // C语言格式
typeName(value);  // C++格式
C++还引入了4个强制类型转换运算符,对他们的使用要求更为严格。
在这四个运算符中,static_cast<>可用于将值从一种数值类型转换为另一种数值类型。例如可以像下面这样将thorn转换为long类型:
int thorn = 1;
static_cast<long>(thorn);
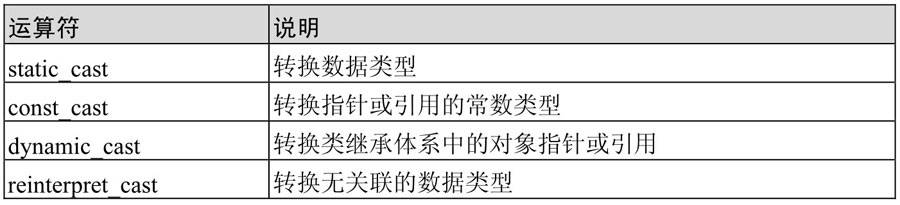
如果从const转换为非const或从volatile转换为非volatile,可以使用const_cast。
这是const_cast惟一允许的转换;如果进行别的转换就可能要使用单独的表达式或者可能会得到一个编译错误。
-
邮箱 :charon.chui@gmail.com
- Good Luck!